Consola de soporte basada en agentes
Consola de soporte integral basada en IA que combina Lakebase, Change Data Feed, un pipeline medallion, un trabajo de agente LLM, sincronización inversa y una Databricks App con analítica de Genie.
Crea con IA
- Copia el prompt siguiente
- Pégalo en Cursor, Claude Code, Codex o cualquier agente de programación
- Tu agente lo crea y te hace preguntas durante el proceso para que el resultado sea exactamente el que quieres
¿No conoces las plantillas? Más información aquí
Incluye una aplicación inicial funcional
El código funcional y ejecutable está en GitHub. Al copiar el prompt anterior, tu agente de programación lo clona como punto de partida y lo adapta a tus datos y caso de uso.
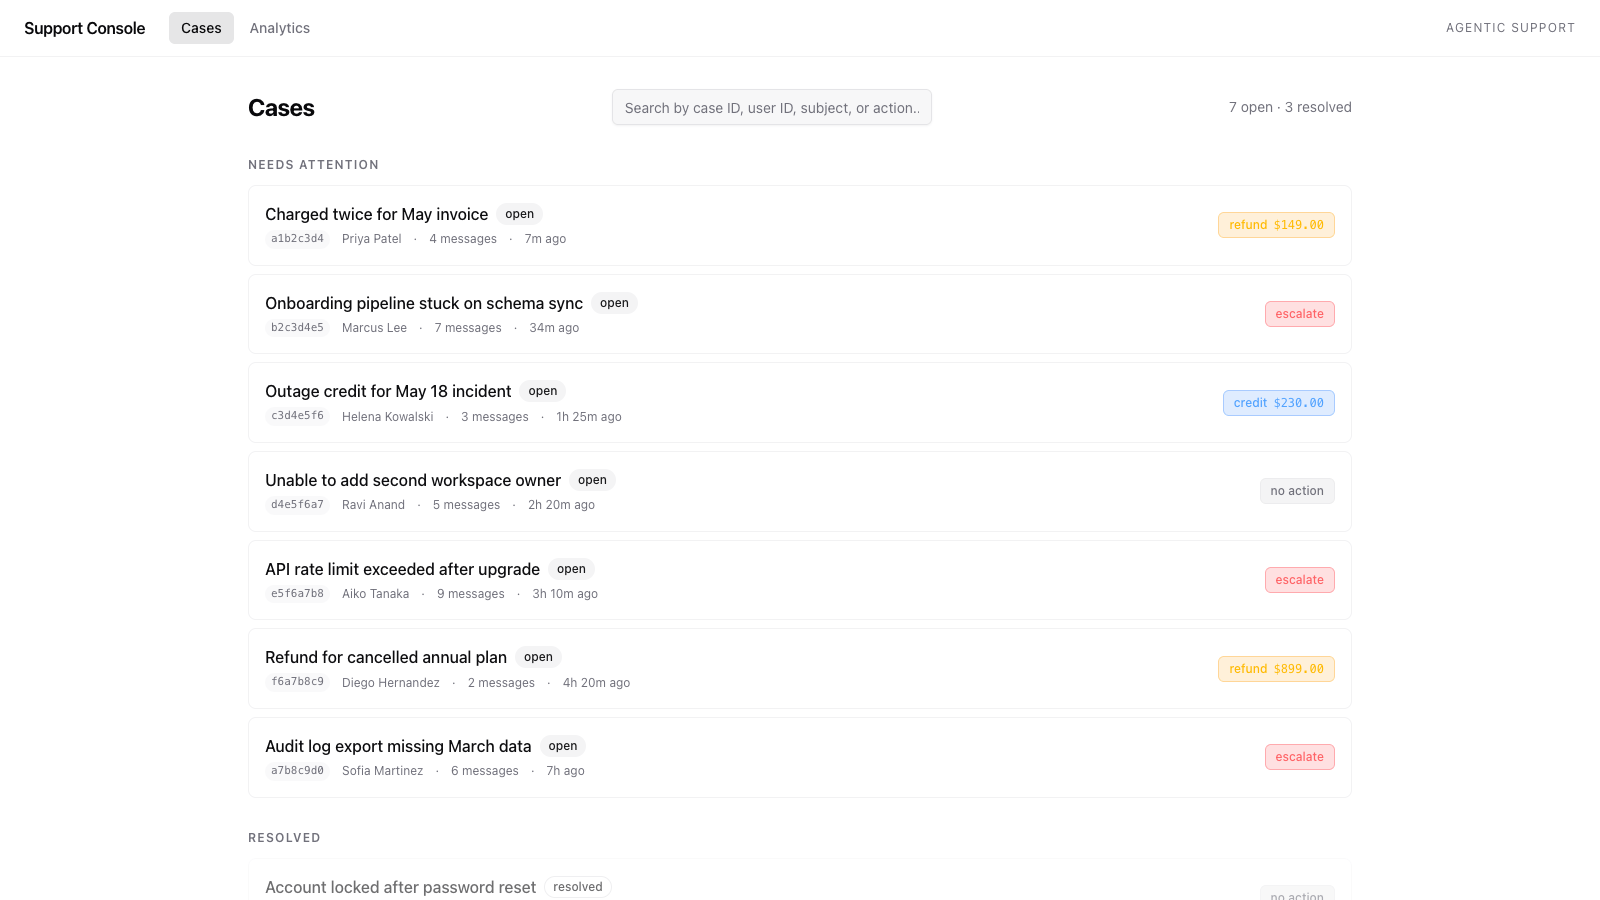
Este template reúne todo el stack de desarrollo de Databricks en una única aplicación de datos operativa: una consola de soporte con IA en la que cada mensaje de un cliente se clasifica automáticamente mediante un LLM, y los agentes de soporte revisan, aprueban o descartan la sugerencia desde una herramienta interna creada a medida.
Flujo de datos
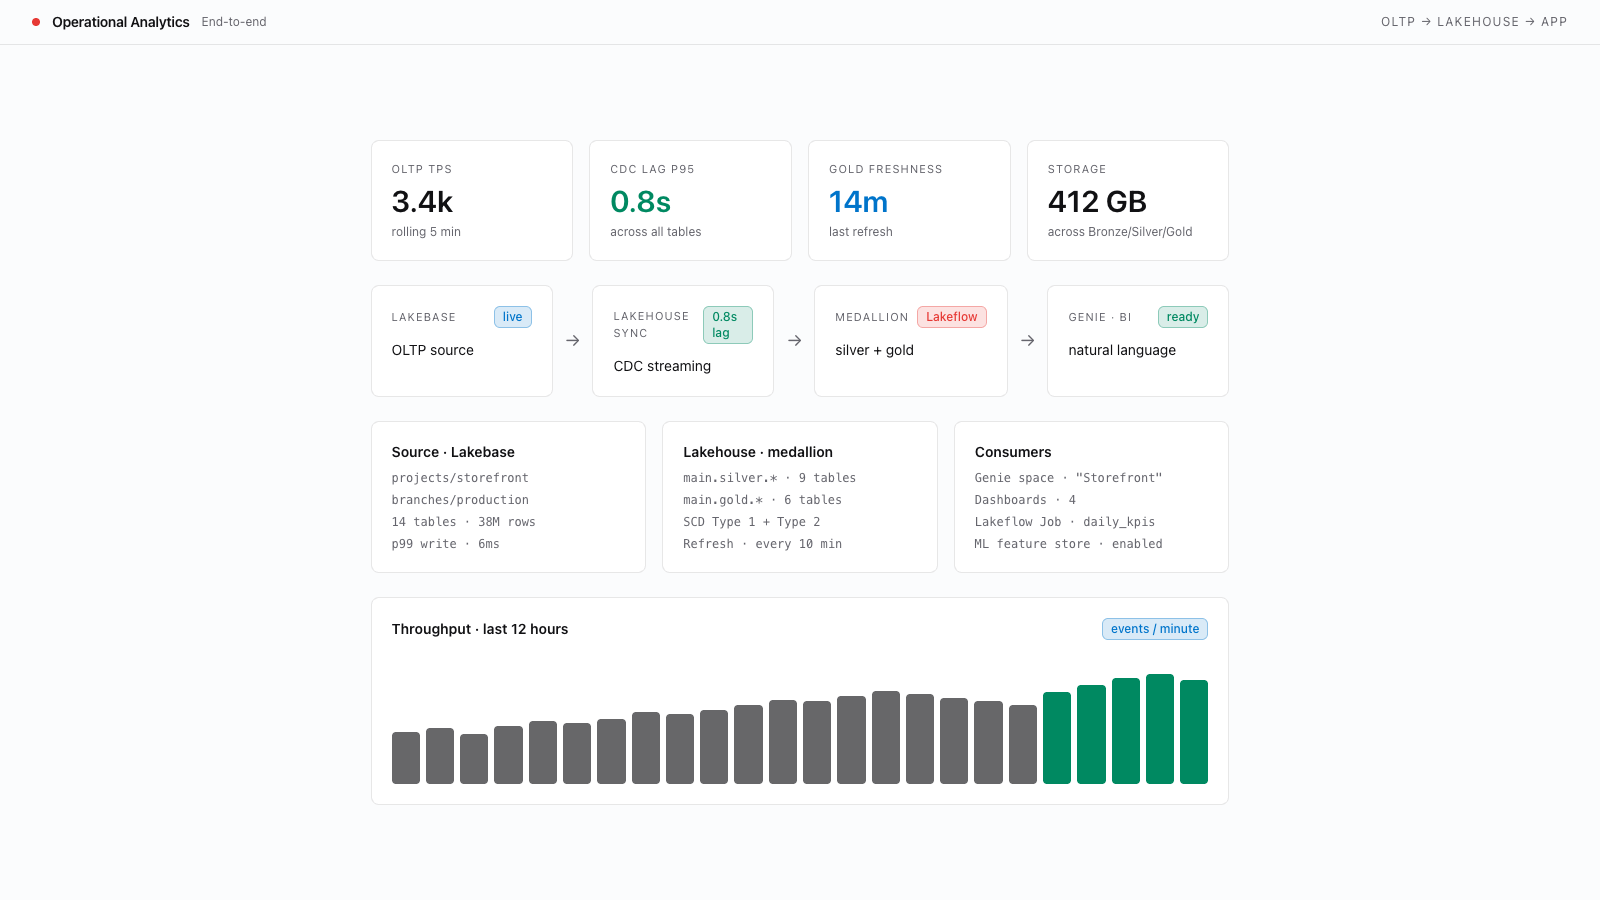
Las interacciones de los clientes fluyen desde la base de datos OLTP de tu aplicación (Lakebase Postgres) hacia el lakehouse mediante CDC, se enriquecen con un agent y se devuelven a la consola de soporte mediante sincronización inversa:
- Las escrituras OLTP llegan a Lakebase Postgres (usuarios, pedidos, casos de soporte, mensajes).
- Lakebase Change Data Feed (CDF) replica cada cambio en Unity Catalog como tablas de historial CDC (capa bronce).
- Un Lakeflow Spark Declarative Pipeline transforma el historial CDC en tablas plata de estado actual y materialized views analíticas de la capa oro (ingresos diarios, panorama de soporte, perfiles de usuario, contexto de casos).
- Un Lakeflow Job se ejecuta cada minuto, detecta los mensajes sin responder, construye un contexto enriquecido a partir de las tablas oro, llama a un LLM mediante un endpoint de serving de Model Serving y combina las respuestas sugeridas en una tabla Delta.
- Las synced tables (sincronización inversa) replican las tablas oro de vuelta en Lakebase para lecturas de baja latencia.
- La consola de soporte (Databricks App) lee tanto de las tablas OLTP como de las tablas oro sincronizadas para mostrar casos, sugerencias de IA y análisis.
Qué adaptar
El aprovisionamiento (pasos manuales y SQL), la carga inicial de datos, los despliegues de pipelines, la sincronización inversa y el despliegue de la app están documentados en el README.md del repositorio, junto al código.
Para adaptar este template a tus necesidades:
- Catálogo: asigna a la variable
catalogdeldatabricks.ymlde cada pipeline el nombre de tu catálogo de Unity Catalog. - Lakebase: apunta el
databricks.ymlde la app a tu propio project, branch y base de datos de Lakebase. - Tablas: el script de carga inicial crea el schema OLTP. Una vez hecha la carga, configura Change Data Feed para replicar las tablas de tu schema
public. - Sync Tables: crea manualmente las cuatro configuraciones de sincronización inversa (consulta el README para ver las correspondencias exactas entre tablas).
- Endpoint de serving: asigna a la variable
endpointel endpoint de serving de modelos que prefieras. - Genie Agent: crea un Genie Agent sobre tus tablas oro y define
genie_space_iden el bundle de la app.
Basado en estas plantillas
La base de código de este ejemplo y el prompt del agente anterior se basan en las plantillas siguientes. Abre una para profundizar en una técnica específica o aplicarla a otro proyecto.
[PLANTILLAS]
Analítica de datos operativos
Configuración integral para analizar datos de bases de datos operativas en el Lakehouse: Unity Catalog con almacenamiento externo, aprovisionamiento de Lakebase, replicación de Lakebase Change Data Feed (CDF) y un pipeline de arquitectura medallion con capas silver y gold.

[PLANTILLAS]
Aplicación con Lakebase
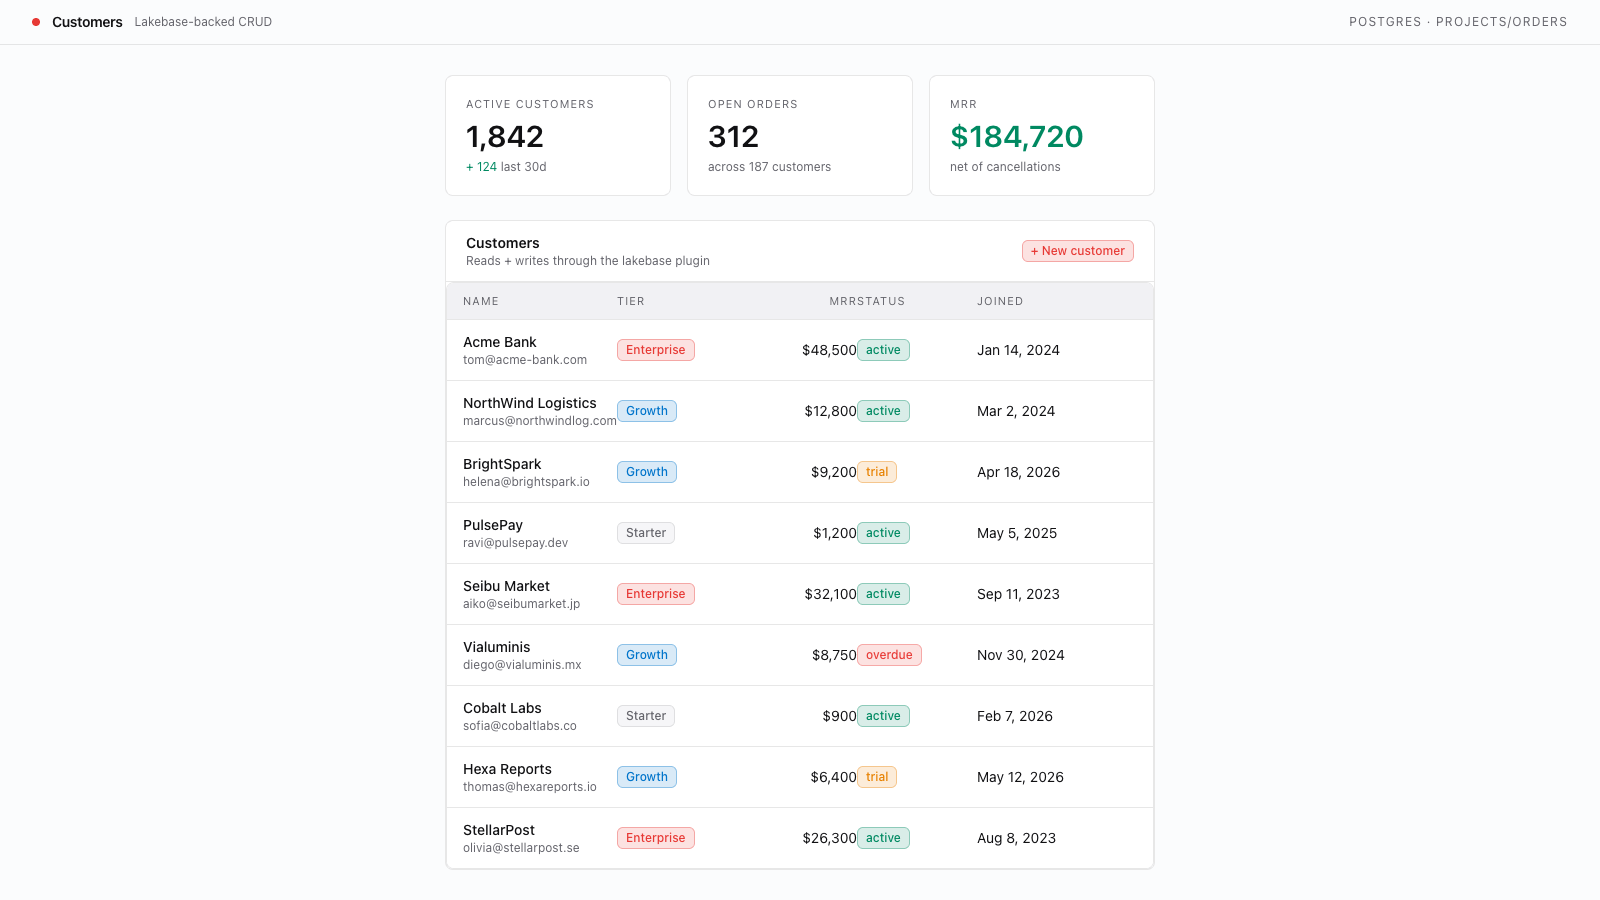
Conecta una Databricks App con Lakebase para almacenar datos de forma persistente. Incluye configuración de esquemas y rutas completas de API para CRUD.
[PLANTILLAS]
Analítica conversacional de Genie
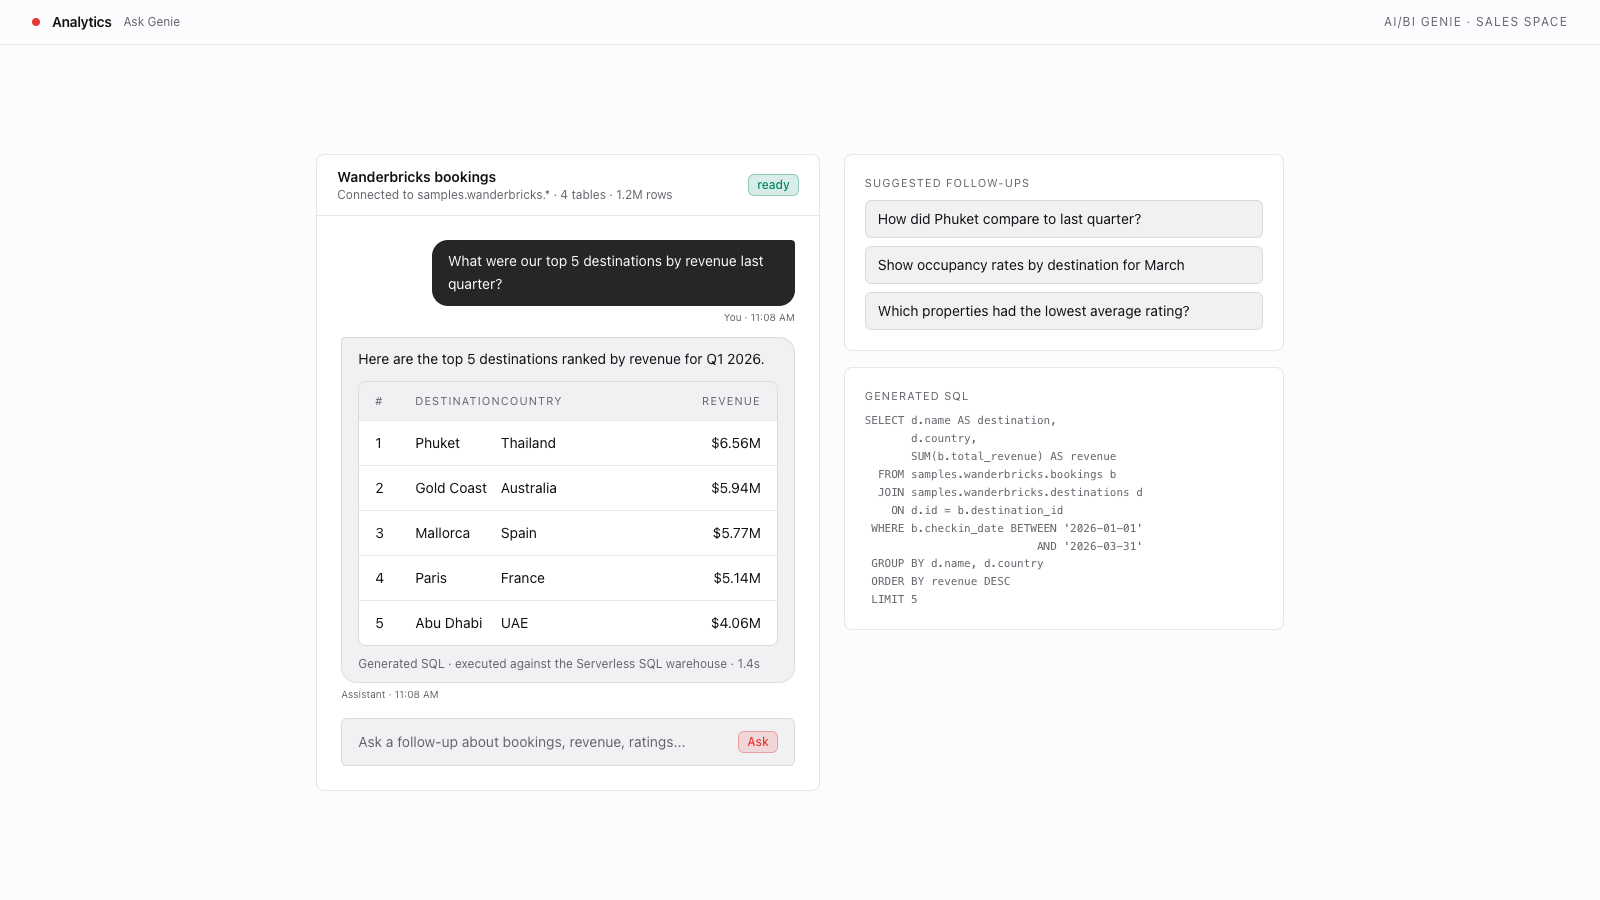
Incorpora una interfaz de chat de Databricks AI/BI Genie para que los usuarios exploren datos mediante lenguaje natural. Configura un Genie Agent, conecta plugins de servidor y cliente, declara recursos de la aplicación e impleméntala.
[PLANTILLAS]
Consulta endpoints de modelos fundacionales
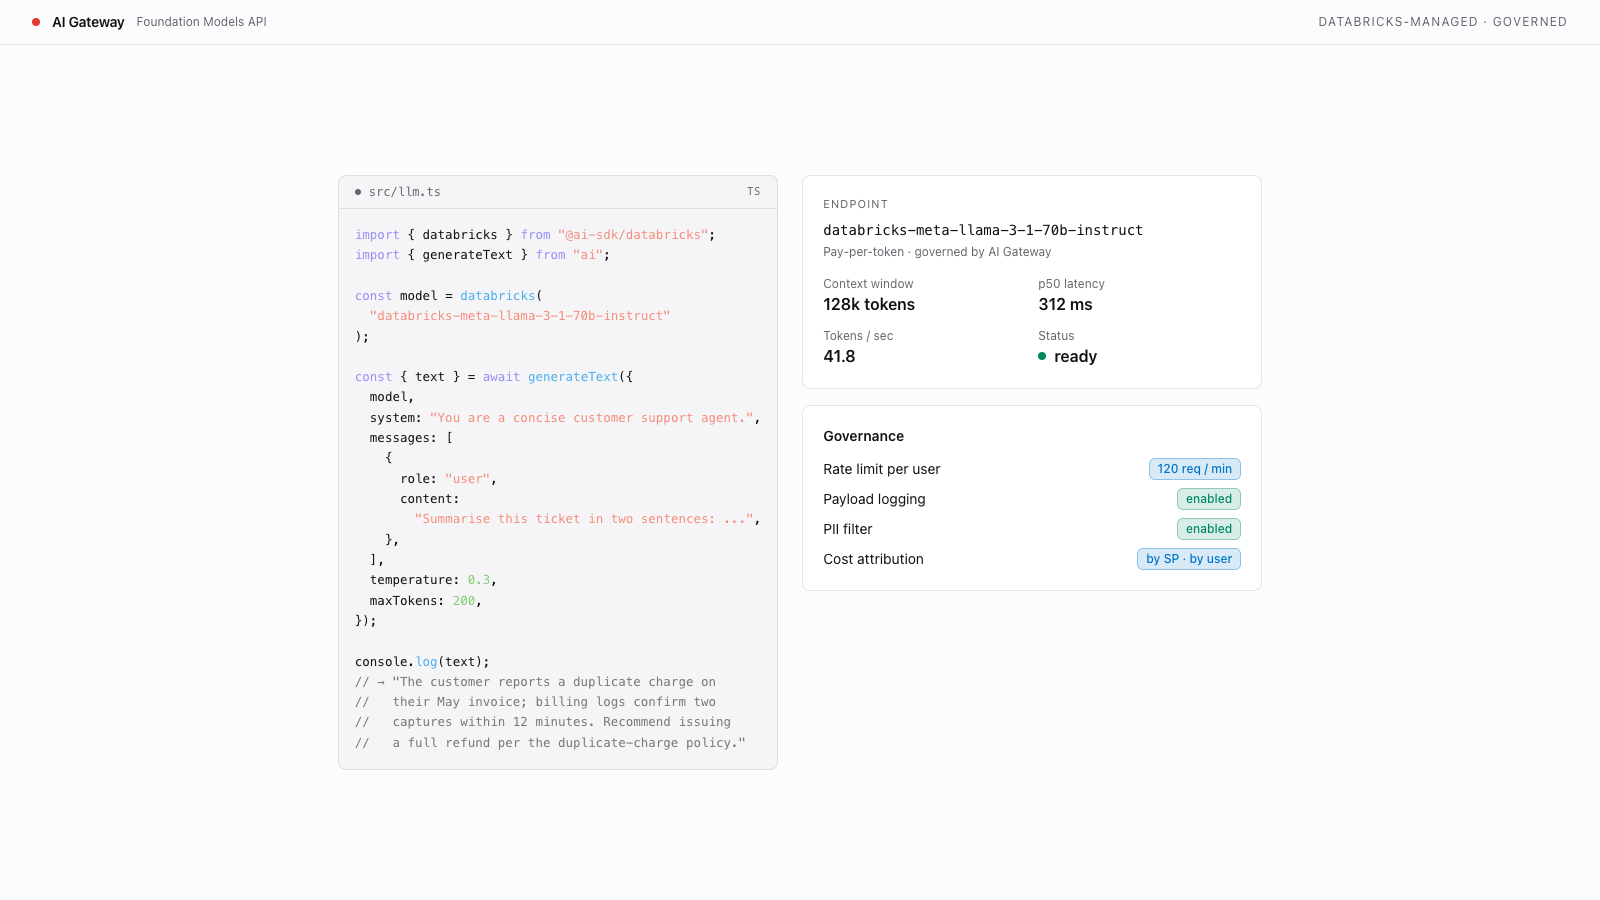
Consulta endpoints de modelos fundacionales de Databricks para acceder en producción a modelos alojados con gobernanza integrada de AI Gateway.