Arquitectura medallion a partir de tablas de historial de CDC
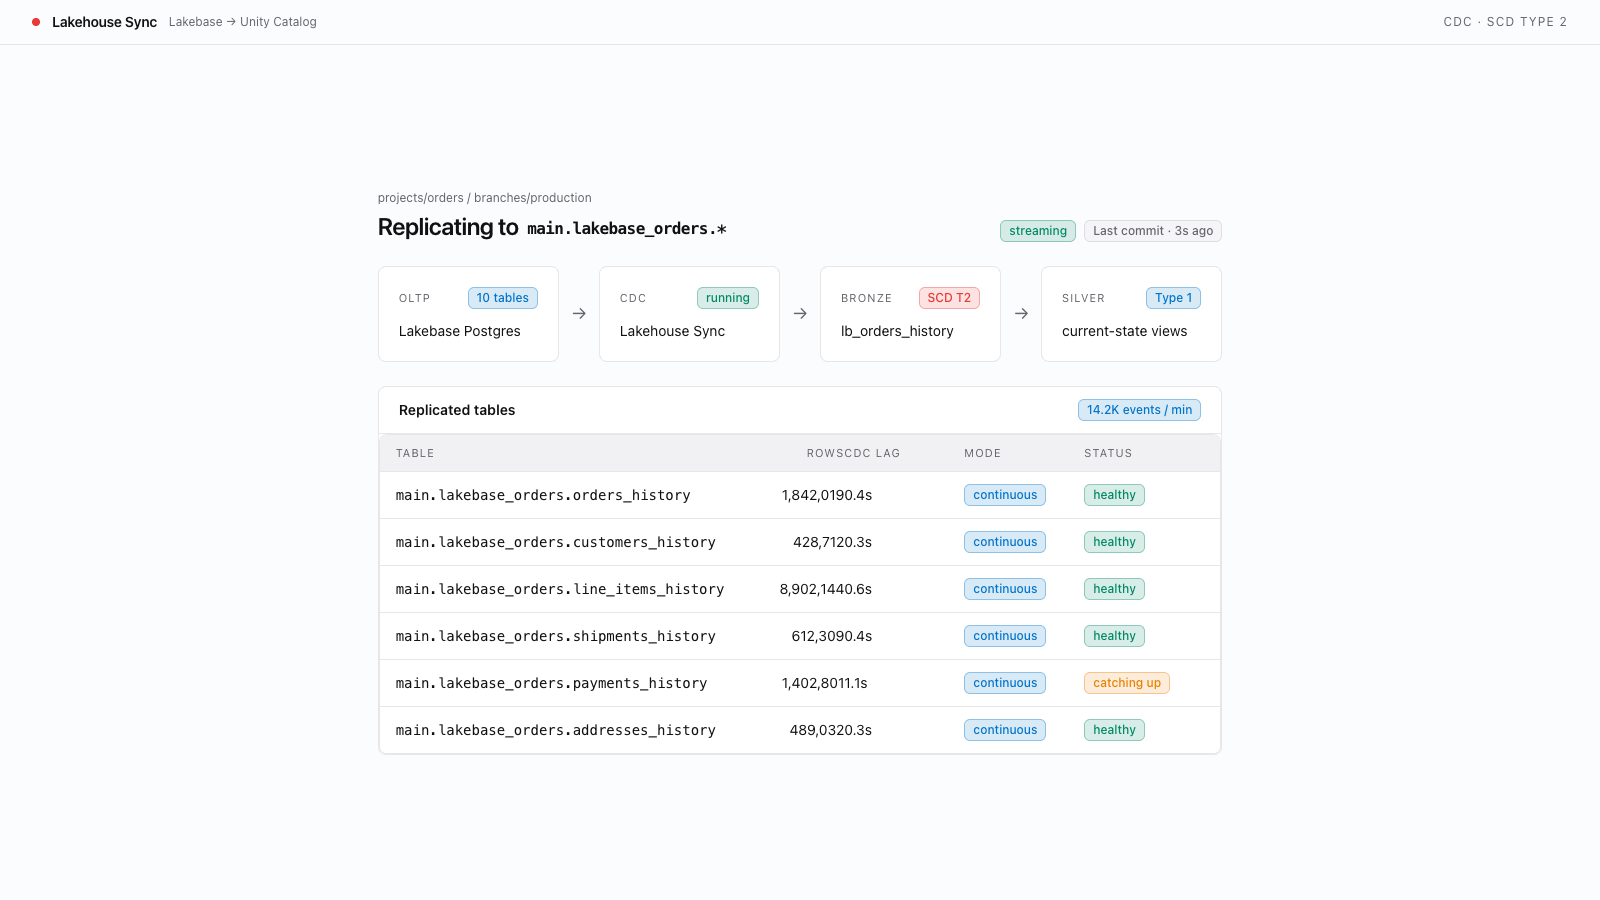
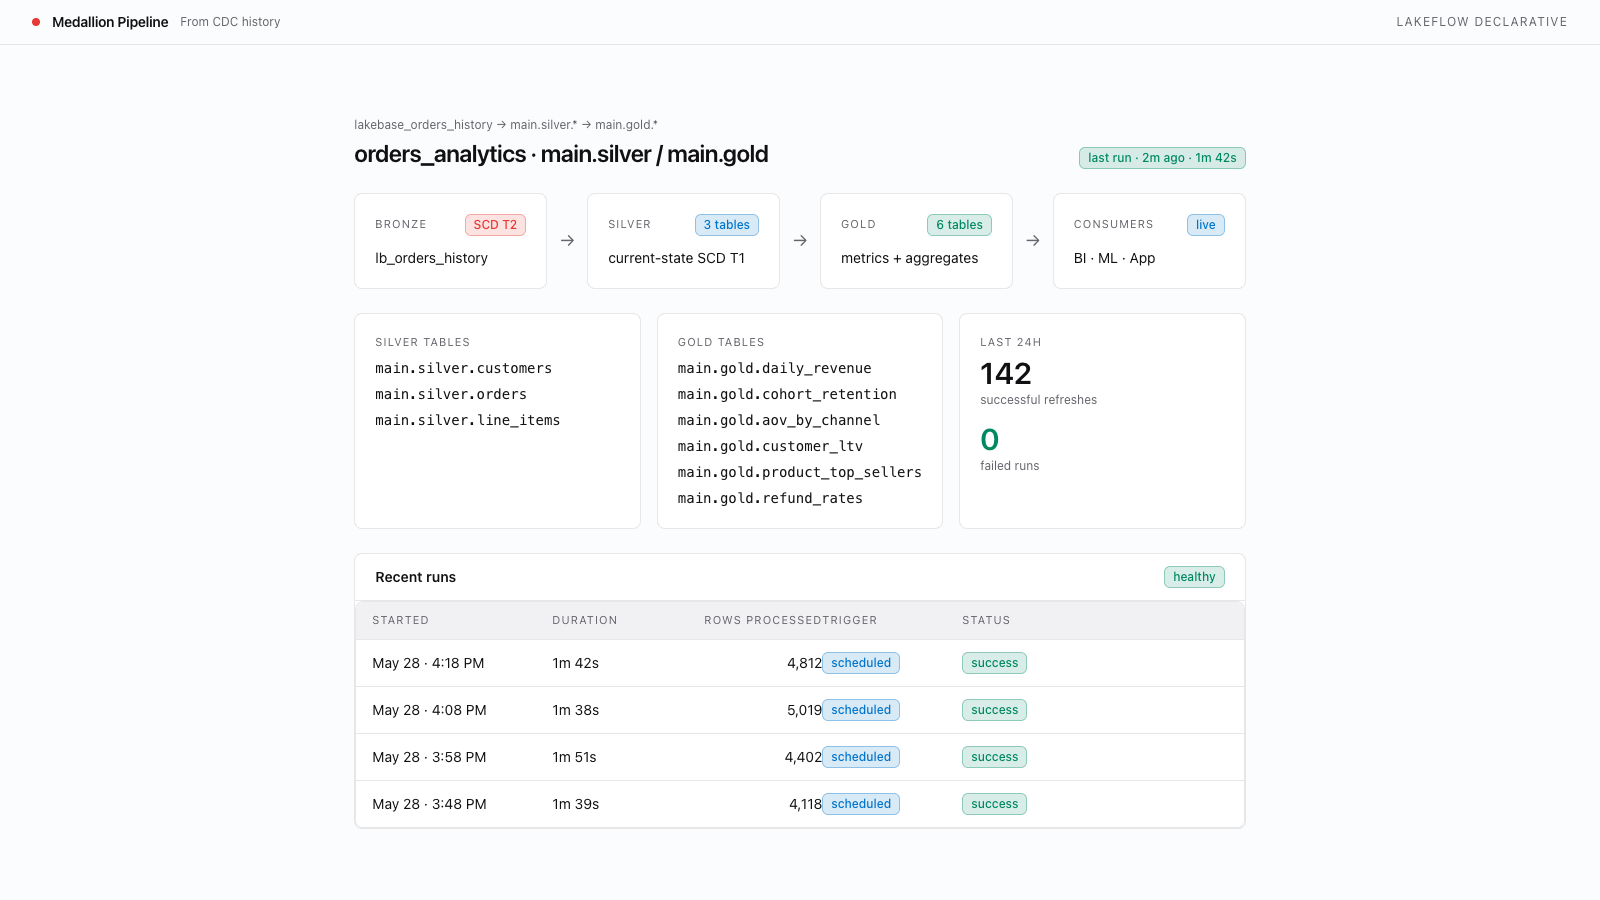
Transforma tablas de historial de Lakebase Change Data Feed en una arquitectura medallion con capas silver (estado actual) y gold (agregaciones) mediante Lakeflow Spark Declarative Pipelines.
Crea con IA
- Copia el prompt siguiente
- Pégalo en Cursor, Claude Code, Codex o cualquier agente de programación
- Tu agente lo crea y te hace preguntas durante el proceso para que el resultado sea exactamente el que quieres
¿No conoces las plantillas? Más información aquí
Al finalizar, tendrás:
- Una capa bronce proporcionada por las tablas de historial de Change Data Feed de Lakebase upstream (entrada de esta receta)
- Una capa plata con materialized views de estado actual, sin duplicados, para cada entidad
- Una capa oro con agregaciones y métricas de negocio en forma de materialized views
- Un Lakeflow Spark Declarative Pipeline programado que refresca las capas plata y oro de forma incremental
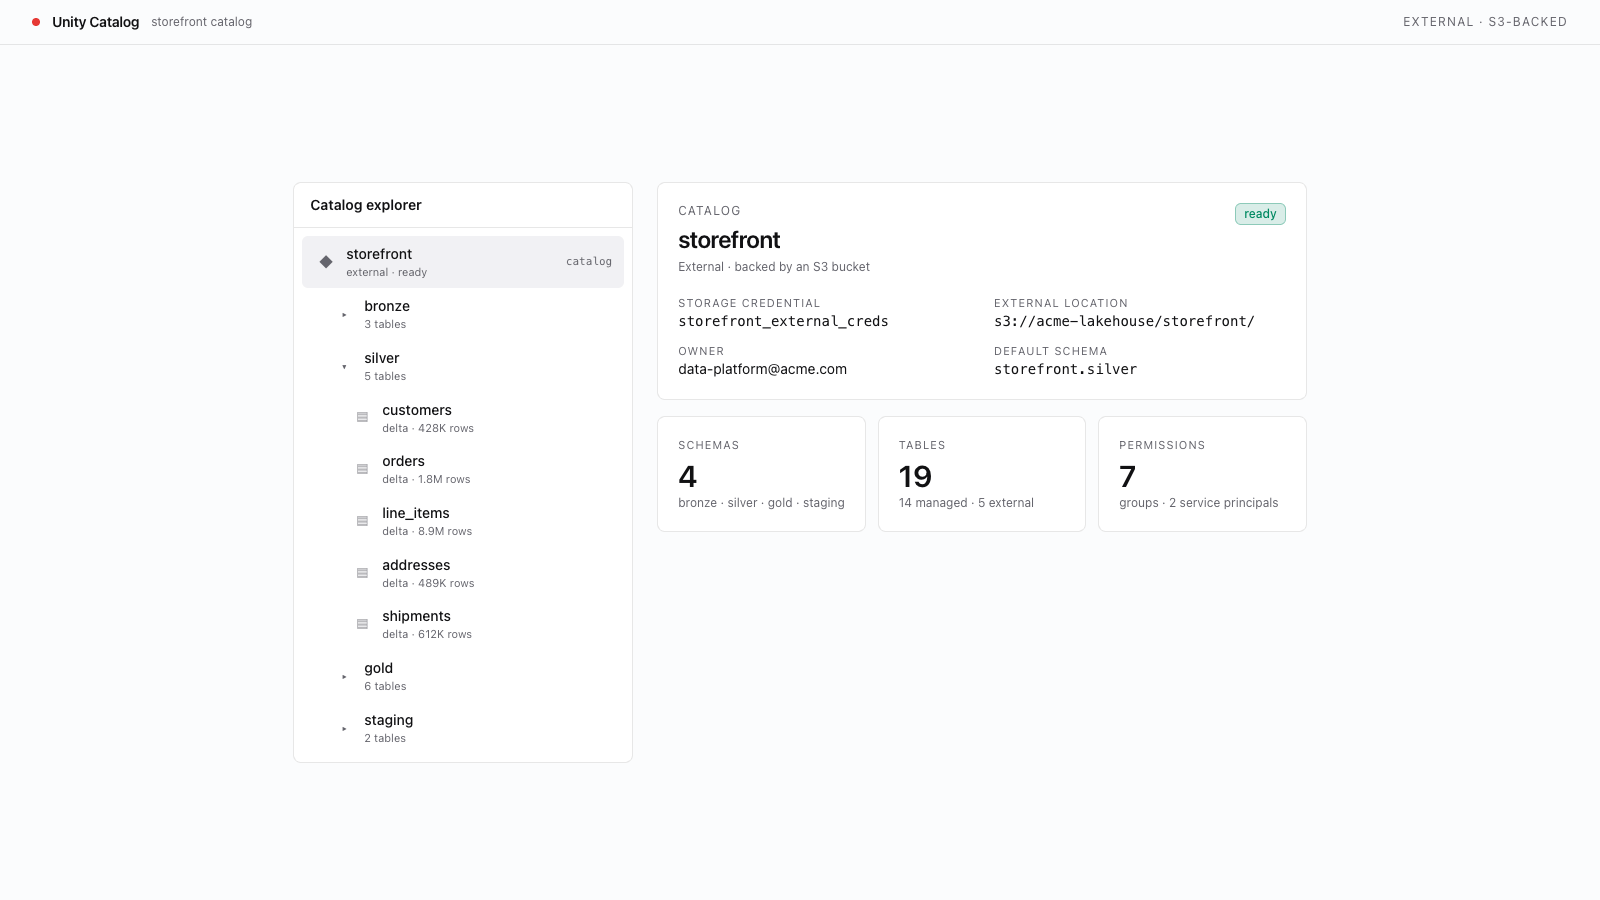
- Todas las capas consultables como tablas de Unity Catalog mediante SQL, Spark, herramientas de BI y Genie
Prerequisites
Este template crea un Lakeflow Spark Declarative Pipeline sobre tablas de historial de Change Data Feed (CDF) de Lakebase ya existentes. Antes de comenzar, verifica que estas funcionalidades del workspace de Databricks estén habilitadas.
- Lakeflow Spark Declarative Pipelines (serverless) disponible. Ejecuta
databricks pipelines list-pipelines --profile <PROFILE>y confirma que el comando se ejecute correctamente (no pasa nada si la lista está vacía). Un error de permisos onot enabledindica que Lakeflow Pipelines no está disponible para esta identidad. - Acceso a Unity Catalog con un schema de destino con permisos de escritura. Ejecuta
databricks catalogs list --profile <PROFILE>y confirma que tu catálogo de destino aparezca en la lista. NecesitarásUSE_CATALOGsobre el catálogo yUSE_SCHEMA+CREATE_MATERIALIZED_VIEWsobre el schema de destino para publicar las materialized views silver y gold (además deCREATE_TABLEsi el pipeline también crea streaming tables). - Tablas de historial CDC bronze ya presentes en Unity Catalog. Completa primero el template Lakebase Change Data Feed (Autoscaling) para que las tablas
lb_<entity>_historyexistan en el schema bronze. Este template lee de esas tablas; no las crea.