Aplicación de chat RAG
Aplicación de chat de generación aumentada por recuperación con streaming, recuperación mediante pgvector desde Lakebase, corpus inicial de Wikipedia, generación con Model Serving e historial de chat respaldado por Lakebase. Se usa mediante `databricks apps init`.
Crea con IA
- Copia el prompt siguiente
- Pégalo en Cursor, Claude Code, Codex o cualquier agente de programación
- Tu agente lo crea y te hace preguntas durante el proceso para que el resultado sea exactamente el que quieres
¿No conoces las plantillas? Más información aquí
Incluye una aplicación inicial funcional
El código funcional y ejecutable está en GitHub. Al copiar el prompt anterior, tu agente de programación lo clona como punto de partida y lo adapta a tus datos y caso de uso.
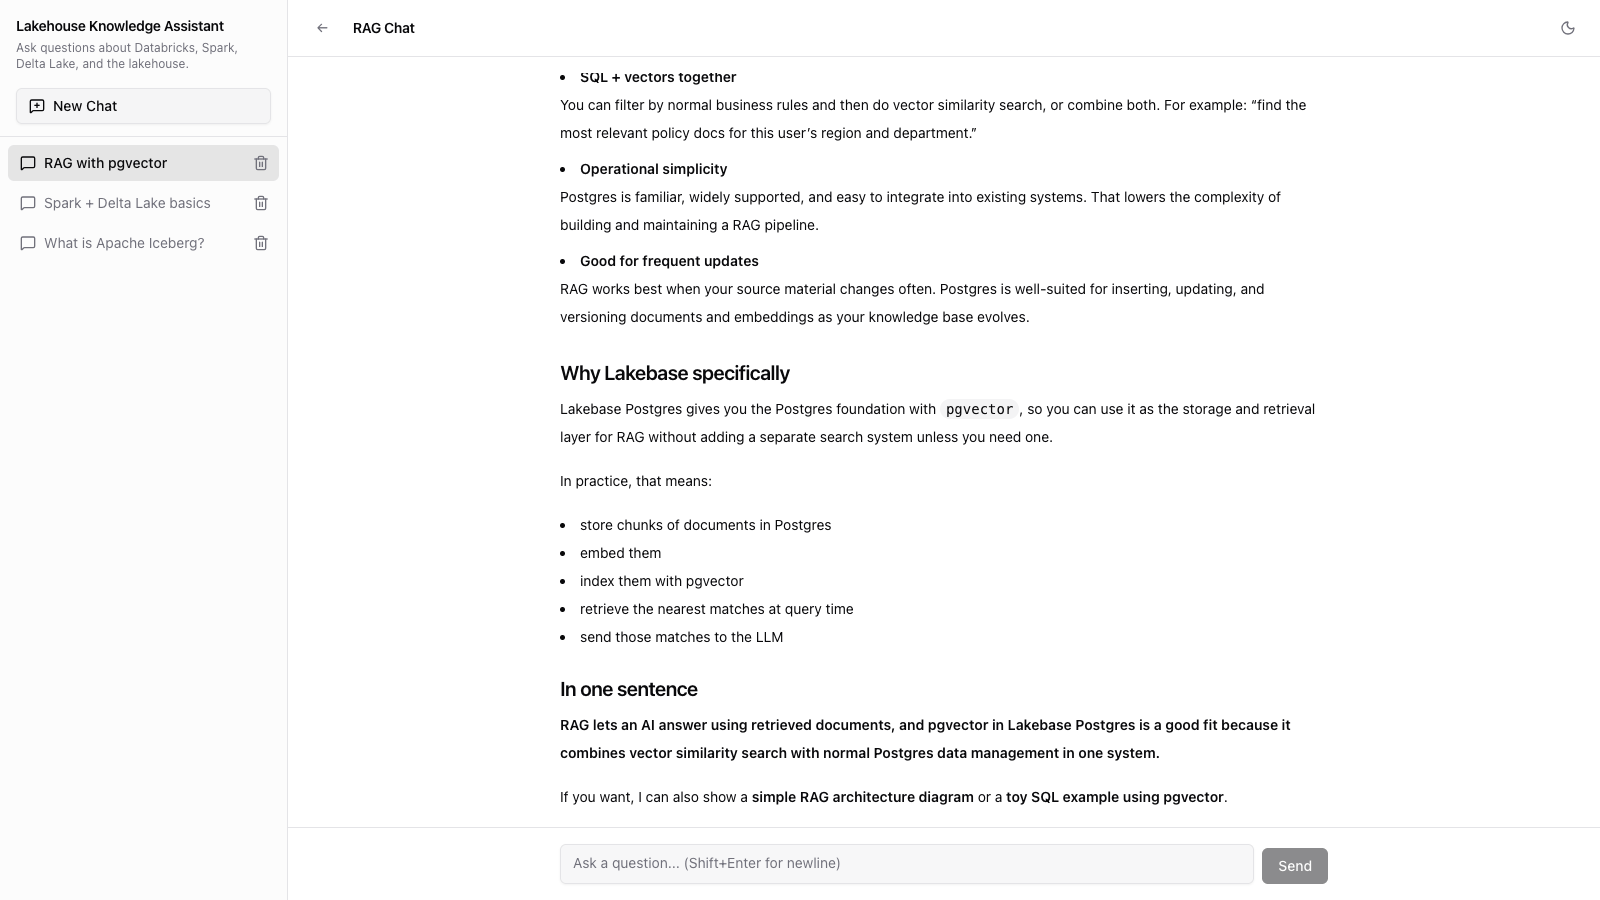
Este template muestra una aplicación de chat con generación aumentada por recuperación (RAG) creada sobre Databricks: la pregunta del usuario se convierte en un embedding, se recuperan documentos similares de un almacén pgvector en Lakebase Postgres y el contexto recuperado se inyecta en una llamada a Model Serving que devuelve la respuesta en streaming. Las conversaciones y las fuentes se conservan por chat en Lakebase.
Flujo de datos
Todo el estado de recuperación y de chat reside en Lakebase Postgres; la generación usa Model Serving:
- La carga inicial obtiene un puñado de artículos de Wikipedia al arrancar, los divide en fragmentos por párrafo, genera los embeddings de cada fragmento mediante el endpoint de embeddings del modelo fundacional (
databricks-gte-large-ende forma predeterminada) y escribe las filas enrag.documentscon una columnavector(1024). - Los turnos del usuario se convierten en embeddings con el mismo endpoint. El servidor ejecuta una búsqueda de similitud por coseno con pgvector para recuperar los k fragmentos más similares.
- Inyección de contexto: los fragmentos recuperados se anteponen como mensaje de sistema antes de enviar el historial de conversación del usuario al endpoint de chat completion (
databricks-gpt-5-4-minide forma predeterminada) a través de Model Serving. - Streaming:
streamTextdevuelve los tokens al cliente en streaming mientras una devolución de llamadaonFinishañade el turno del asistente a Lakebase. - Historial de chat: cada turno del usuario y del asistente se conserva en
chat.messages, indexado porchat_id, de modo que las conversaciones puedan reanudarse.
Enfoque del template
A diferencia de los demás templates, este template está diseñado para consumirse mediante databricks apps init, no con git clone. El flujo de init:
- Solicita los nombres de la branch de Lakebase Postgres y del recurso de base de datos.
- Resuelve automáticamente
PGHOST,PGDATABASEyLAKEBASE_ENDPOINTen tu archivo.envlocal mediante llamadas a las APIs de Lakebase. - Escribe
DATABRICKS_CONFIG_PROFILEoDATABRICKS_HOSTsegún la configuración de tu CLI de Databricks. - Te deja en un directorio de proyecto listo para ejecutar, con el nombre indicado en
--name.
Esto valida el sistema de templates de AppKit como una forma de distribuir templates de DevHub: consulta appkit.plugins.json y .env.tmpl en el template para ver cómo funciona.
Qué adaptar
El setup y el aprovisionamiento están documentados en el archivo README.md del repositorio.
Para hacer tuyo este template:
- Lakebase: Apunta el bundle a tu propio project, branch y base de datos de Lakebase (se te solicitan al inicializar).
- Model Serving endpoint: Sobrescribe
DATABRICKS_ENDPOINTpara usar otro modelo de chat (por ejemplo,databricks-claude-sonnet-4-6). - Endpoint de embeddings: Sobrescribe
DATABRICKS_EMBEDDING_ENDPOINTsi quieres usar otro modelo de embeddings. Asegúrate de que coincida la dimensiónvector(N)enserver/lib/rag-store.ts. - Datos semilla: Sustituye la lista de artículos de Wikipedia en
server/lib/seed-data.tspor tu propio corpus. La función de fragmentación divide el texto en los límites de los párrafos: adáptala si tu fuente tiene otra estructura. - Recuperación: El top-k predeterminado es 5 y la métrica de similitud es el coseno. Ajústalos en
retrieveSimilar().
Basado en estas plantillas
La base de código de este ejemplo y el prompt del agente anterior se basan en las plantillas siguientes. Abre una para profundizar en una técnica específica o aplicarla a otro proyecto.
[PLANTILLAS]
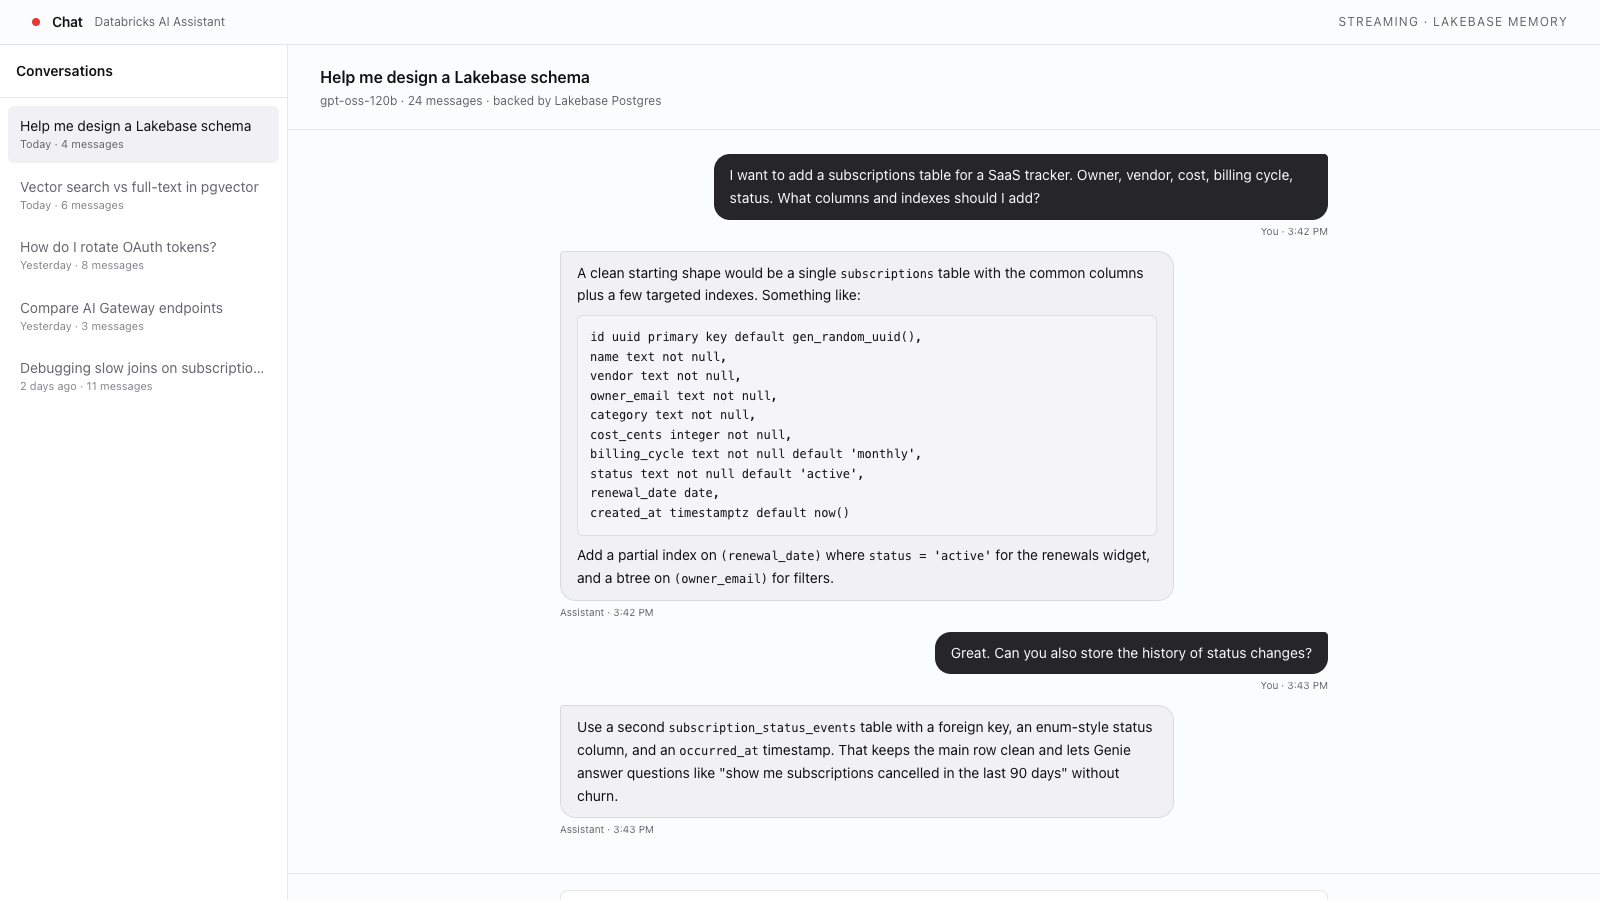
Aplicación de chat de IA
Integración de Model Serving, chat en streaming con AI SDK e historial de chat persistido en Lakebase.

[PLANTILLAS]
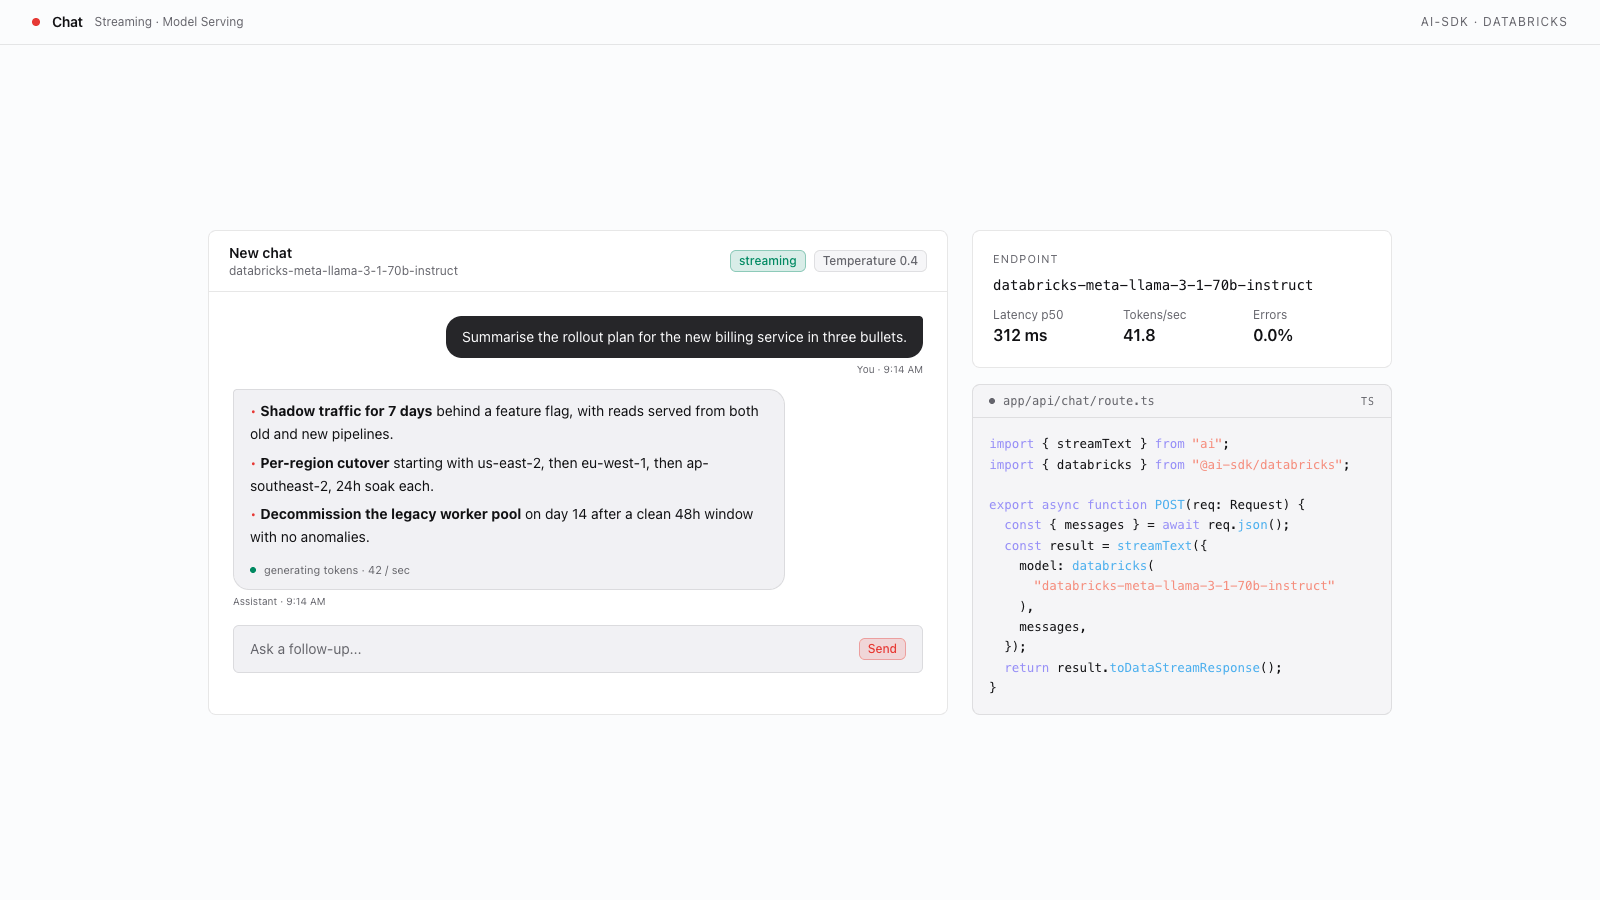
Chat de IA en streaming con Model Serving
Crea una experiencia de chat de IA en streaming con AI SDK y endpoints de Databricks Model Serving.
[PLANTILLAS]
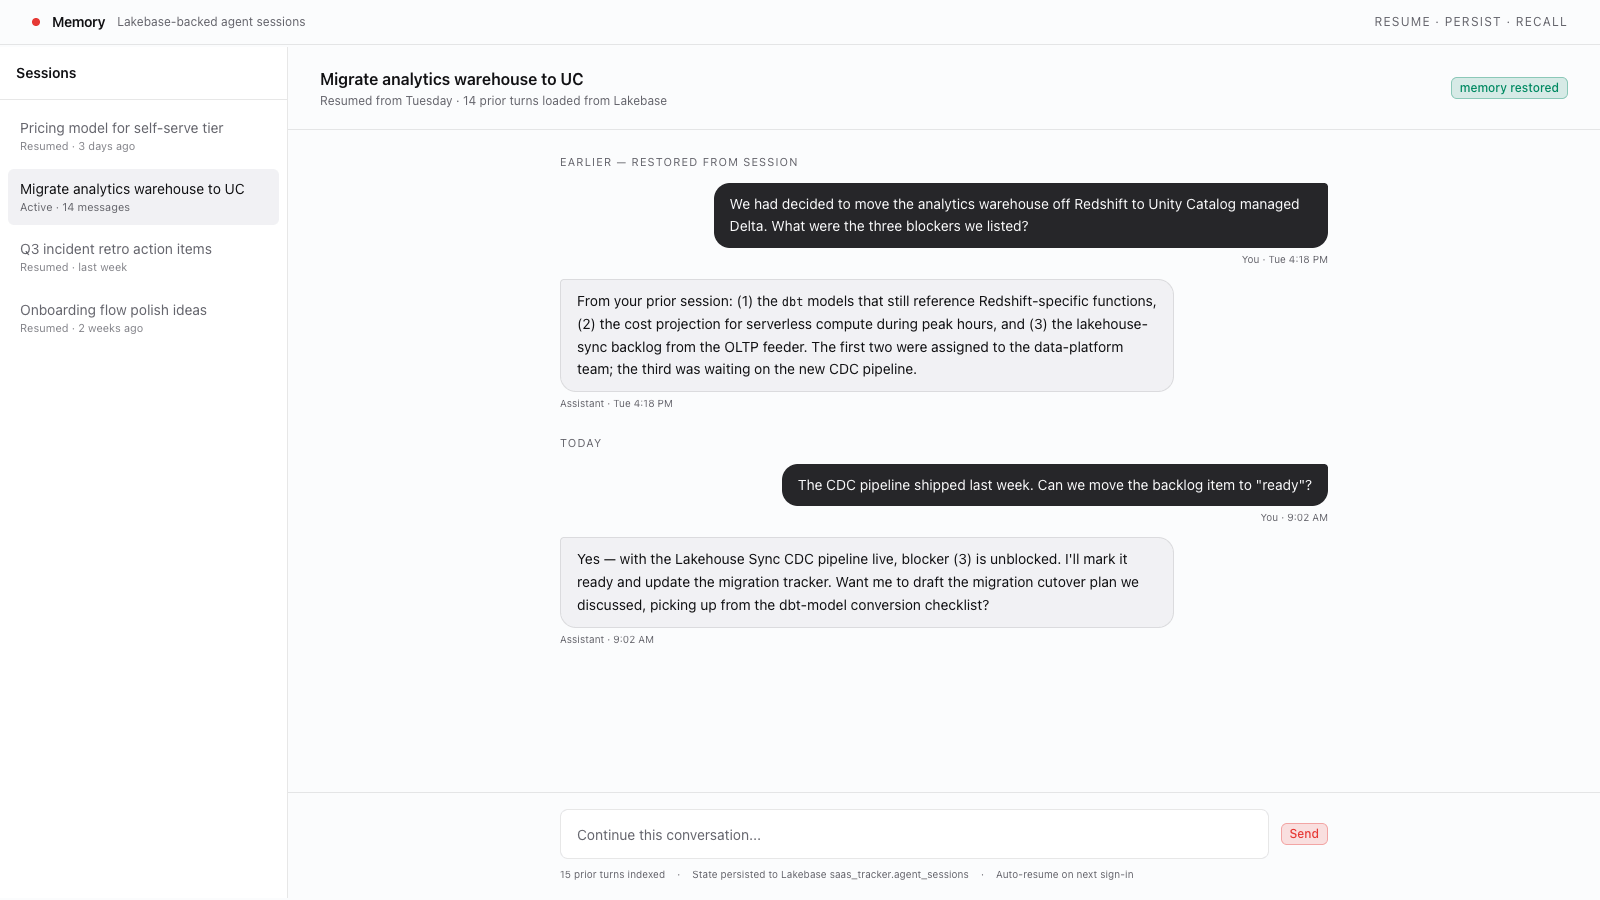
Memoria de agentes de Lakebase
Guarda las sesiones y los mensajes de chat de tu agente de IA en Lakebase para que los usuarios puedan reanudar conversaciones y tu agente pueda razonar sobre turnos anteriores entre implementaciones.