Sincroniza tablas: de Unity Catalog a Lakebase (Autoscaling)
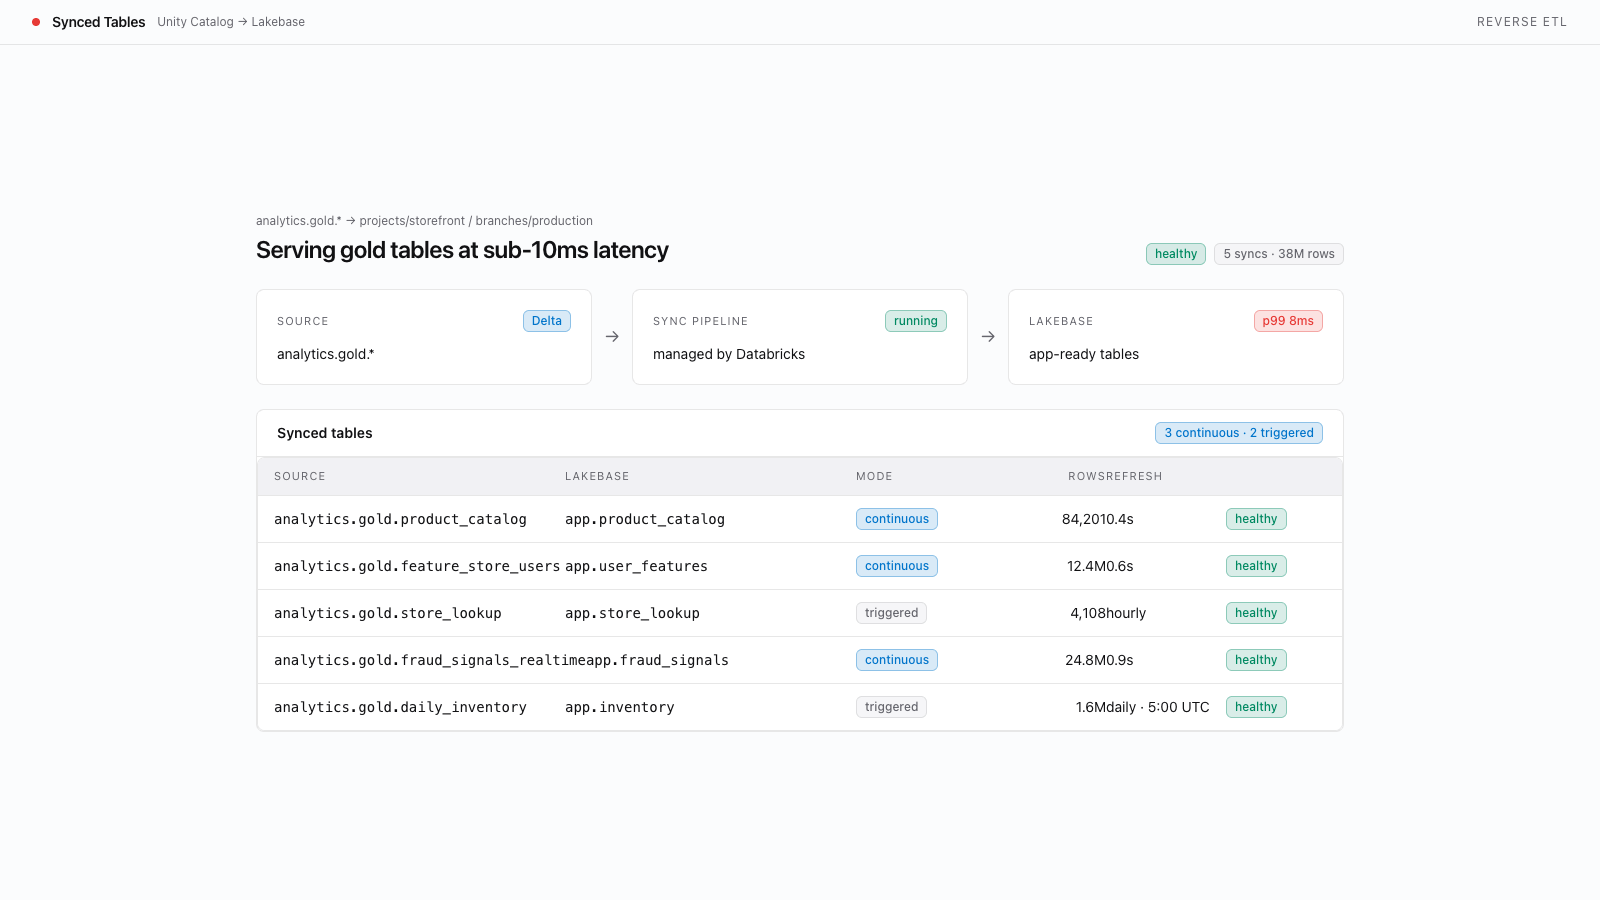
Sincroniza tablas de Unity Catalog con Lakebase Autoscaling Postgres como tablas sincronizadas para consultas de aplicaciones de baja latencia, con modos de instantánea, bajo demanda o continuo.
Crea con IA
- Copia el prompt siguiente
- Pégalo en Cursor, Claude Code, Codex o cualquier agente de programación
- Tu agente lo crea y te hace preguntas durante el proceso para que el resultado sea exactamente el que quieres
¿No conoces las plantillas? Más información aquí
Al terminar, tendrás:
- Una tabla sincronizada en Unity Catalog que hace seguimiento del pipeline de replicación
- Una tabla de Postgres de solo lectura en Lakebase que puedes consultar con baja latencia desde cualquier cliente estándar de Postgres
- Un pipeline gestionado de Lakeflow que mantiene los datos sincronizados en modo instantánea, activado o continuo
Prerequisites
Este template crea una tabla sincronizada que replica una tabla de Unity Catalog en Lakebase Postgres. Verifica que estas funcionalidades del workspace de Databricks estén habilitadas antes de comenzar.
- Lakebase Autoscaling disponible. Ejecuta
databricks postgres list-projects --profile <PROFILE>y confirma que tu project de Autoscaling aparezca en la lista. Un errornot enabledsignifica que Lakebase no está disponible para esta identidad. - CLI con soporte para tablas sincronizadas. Las tablas sincronizadas en projects de Autoscaling se crean con
databricks postgres create-synced-table(Beta). Ejecutadatabricks postgres create-synced-table --helpy confirma que el comando exista; si no, actualiza el CLI de Databricks. También puedes crear tablas sincronizadas desde la UI de Databricks (Catalog → tabla de origen → Create synced table). - Tabla de origen en Unity Catalog. Ejecuta
databricks tables get <CATALOG>.<SCHEMA>.<SOURCE_TABLE> --profile <PROFILE>y confirma que el origen exista; luego decide qué columna(s) funcionarán como clave primaria de la tabla sincronizada: se pasan comoprimary_key_columnsen la especificación de creación. El origen no necesita tener declarada una restricción de clave primaria. - Change Data Feed habilitado en la tabla de origen (solo para el modo Triggered / Continuous). Omite esta verificación si planeas usar el modo Snapshot. De lo contrario, ejecuta la sentencia
ALTER TABLE <catalog>.<schema>.<table> SET TBLPROPERTIES (delta.enableChangeDataFeed = true);del Paso 1 en tu SQL warehouse.