Console de support agentique
Console de support de bout en bout optimisée par l’IA, combinant Lakebase, Change Data Feed, un pipeline en médaillon, une tâche d’agent LLM, une synchronisation inverse et une Databricks App avec analyses Genie.
Créer avec l’IA
- Copiez le prompt ci-dessous
- Collez-le dans Cursor, Claude Code, Codex ou tout autre agent de codage
- Votre agent la crée en posant des questions au fil du processus afin que le résultat corresponde exactement à vos attentes
Vous découvrez les modèles ? En savoir plus ici
Inclut une application de démarrage fonctionnelle
Du code réel et exécutable est disponible sur GitHub. Lorsque vous copiez le prompt ci-dessus, votre agent de codage le clone comme point de départ et l’adapte à vos données et à votre cas d’utilisation.
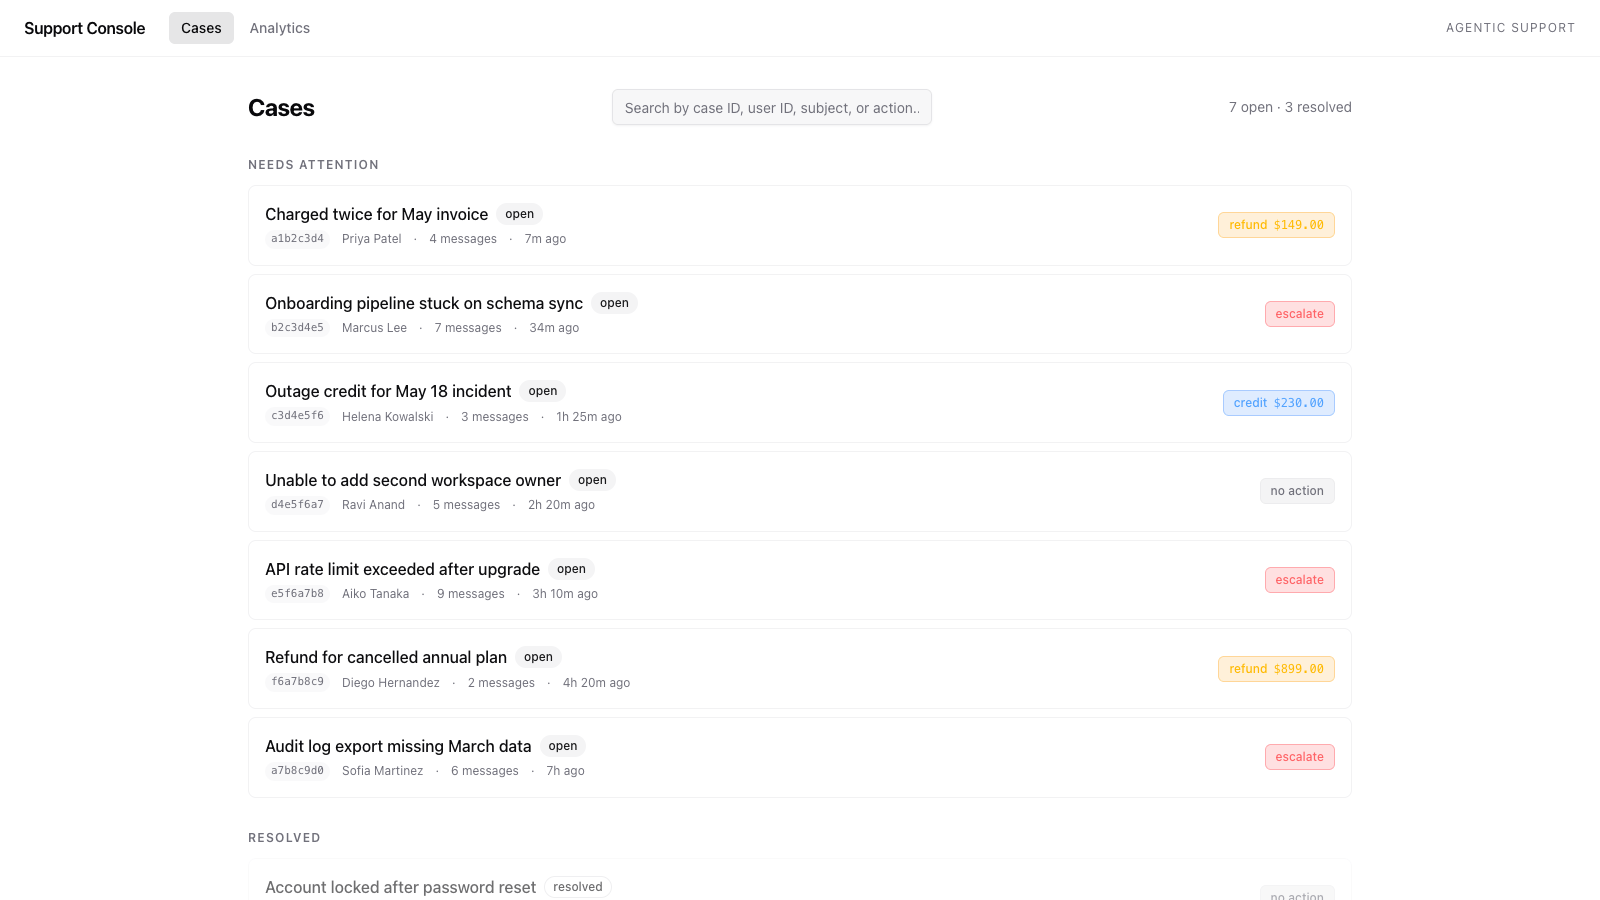
Ce modèle réunit toute la pile de développement Databricks dans une seule application de données opérationnelle : une console de support propulsée par l'IA, où chaque message client est automatiquement trié par un LLM et où les agents du support examinent, approuvent ou corrigent la suggestion depuis un outil interne conçu sur mesure.
Flux de données
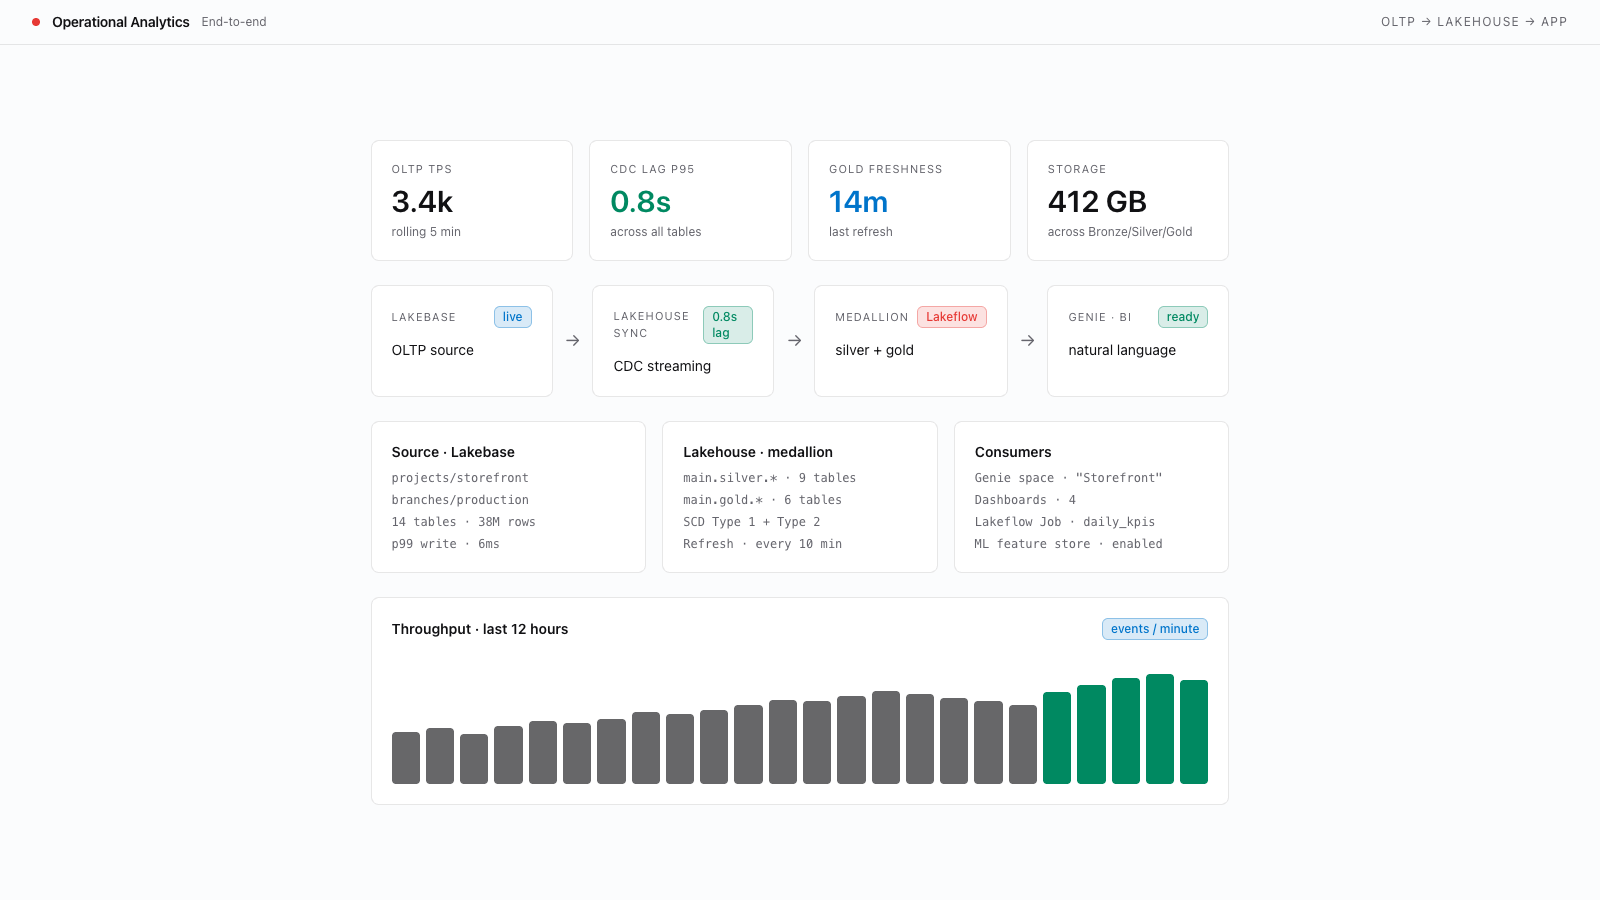
Les interactions client circulent depuis la base de données OLTP de votre application (Lakebase Postgres) vers le lakehouse via le CDC, sont enrichies par un agent IA, puis restituées à la console de support par synchronisation inverse :
- Les écritures OLTP arrivent dans Lakebase Postgres (utilisateurs, commandes, tickets de support, messages).
- Le Change Data Feed (CDF) de Lakebase réplique chaque modification dans Unity Catalog sous forme de tables d'historique CDC (couche bronze).
- Un Lakeflow Spark Declarative Pipeline transforme l'historique CDC en tables silver reflétant l'état courant et en vues matérialisées gold analytiques (revenu quotidien, vue d'ensemble du support, profils utilisateurs, contexte des tickets).
- Un Lakeflow Job s'exécute chaque minute : il repère les messages sans réponse, constitue un contexte riche à partir des tables gold, appelle un LLM via un serving endpoint et fusionne les réponses suggérées dans une table Delta.
- Les tables synchronisées (synchronisation inverse) répliquent les tables gold vers Lakebase pour des lectures à faible latence.
- La console de support (Databricks App) lit à la fois les tables OLTP et les tables gold synchronisées pour présenter les tickets, les suggestions de l'IA et les analyses.
Éléments à adapter
Le provisionnement (étapes manuelles et SQL), le chargement initial des données, le déploiement des pipelines, la synchronisation inverse et le déploiement de l'application sont documentés dans le fichier README.md du dépôt, aux côtés du code.
Pour adapter ce modèle à vos besoins :
- Catalogue : définissez la variable
catalogdu fichierdatabricks.ymlde chaque pipeline avec le nom de votre catalogue Unity Catalog. - Lakebase : faites pointer le fichier
databricks.ymlde l'application vers vos propres projet, branche et base de données Lakebase. - Tables : le script de chargement initial crée le schéma OLTP. Une fois les données chargées, configurez Change Data Feed pour répliquer les tables de votre schéma
public. - Tables de synchronisation : créez manuellement les quatre configurations de synchronisation inverse (consultez le README pour connaître les correspondances exactes entre les tables).
- Serving endpoint : définissez la variable
endpointavec le serving endpoint de votre choix. - Genie Agent : créez un Genie Agent sur vos tables gold et renseignez la valeur de
genie_space_iddans le bundle de l'application.
Basé sur ces modèles
Le code de cet exemple et le prompt de l’agent ci-dessus s’appuient tous deux sur les modèles ci-dessous. Ouvrez-en un pour découvrir une technique précise ou l’appliquer à un autre projet.
[MODÈLES]
Analyse des données opérationnelles
Configuration de bout en bout pour analyser les données de bases de données opérationnelles dans le Lakehouse : Unity Catalog avec stockage externe, provisionnement de Lakebase, réplication via Lakebase Change Data Feed (CDF) et pipeline d’architecture en médaillon avec couches silver et gold.

[MODÈLES]
Application avec Lakebase
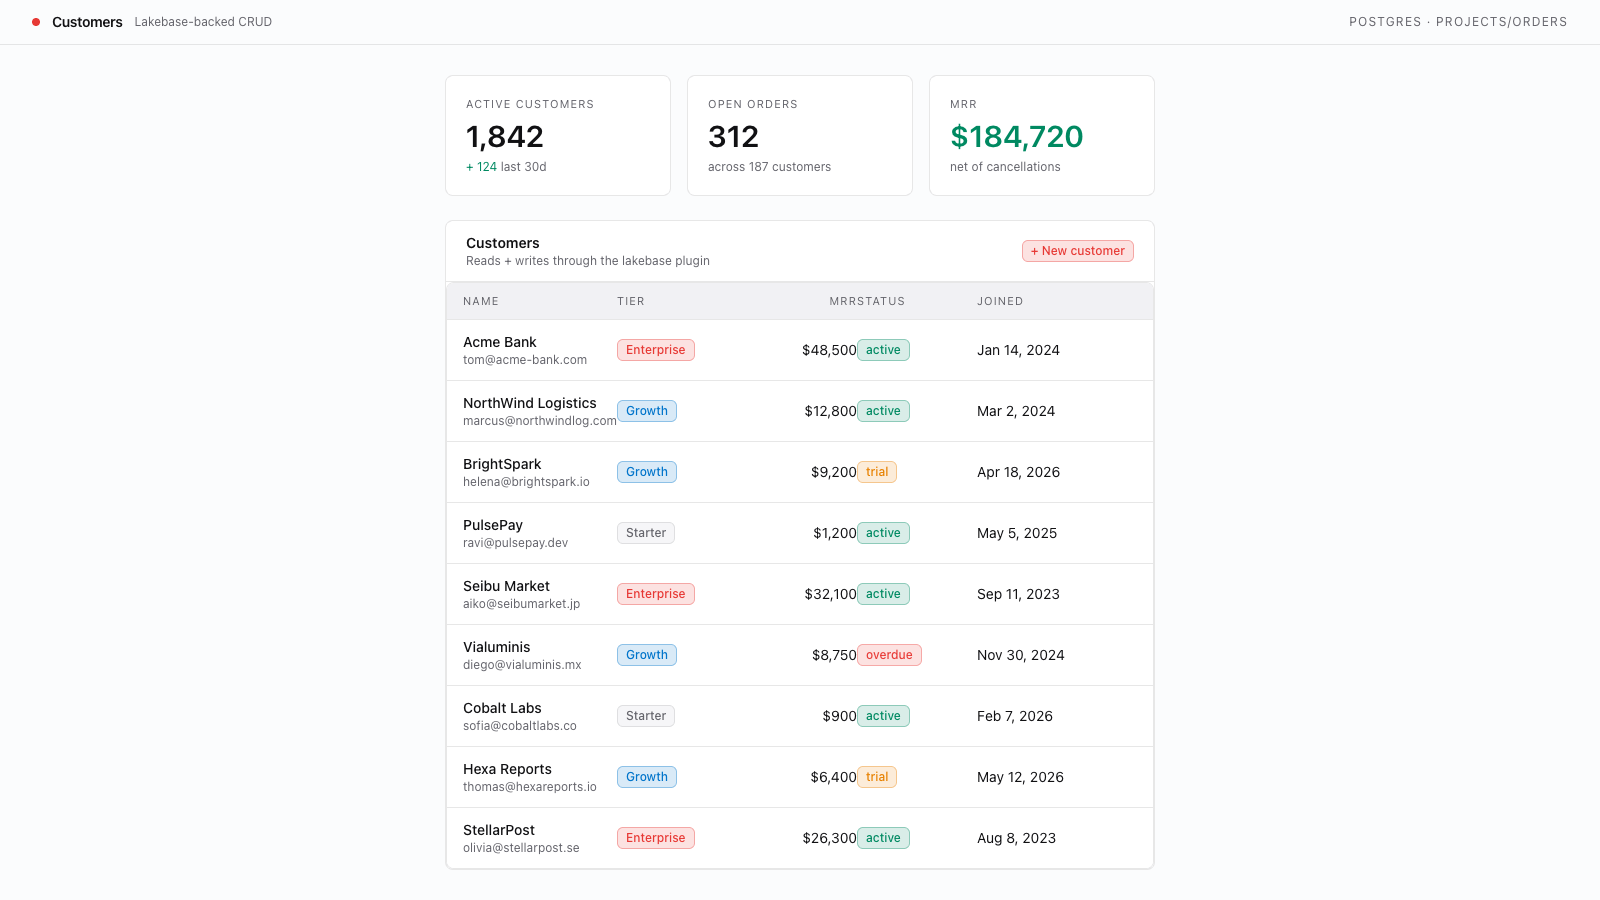
Connectez une Databricks App à Lakebase pour assurer un stockage persistant des données. Inclut la configuration du schéma et des routes d’API CRUD complètes.
[MODÈLES]
Analytique conversationnelle Genie
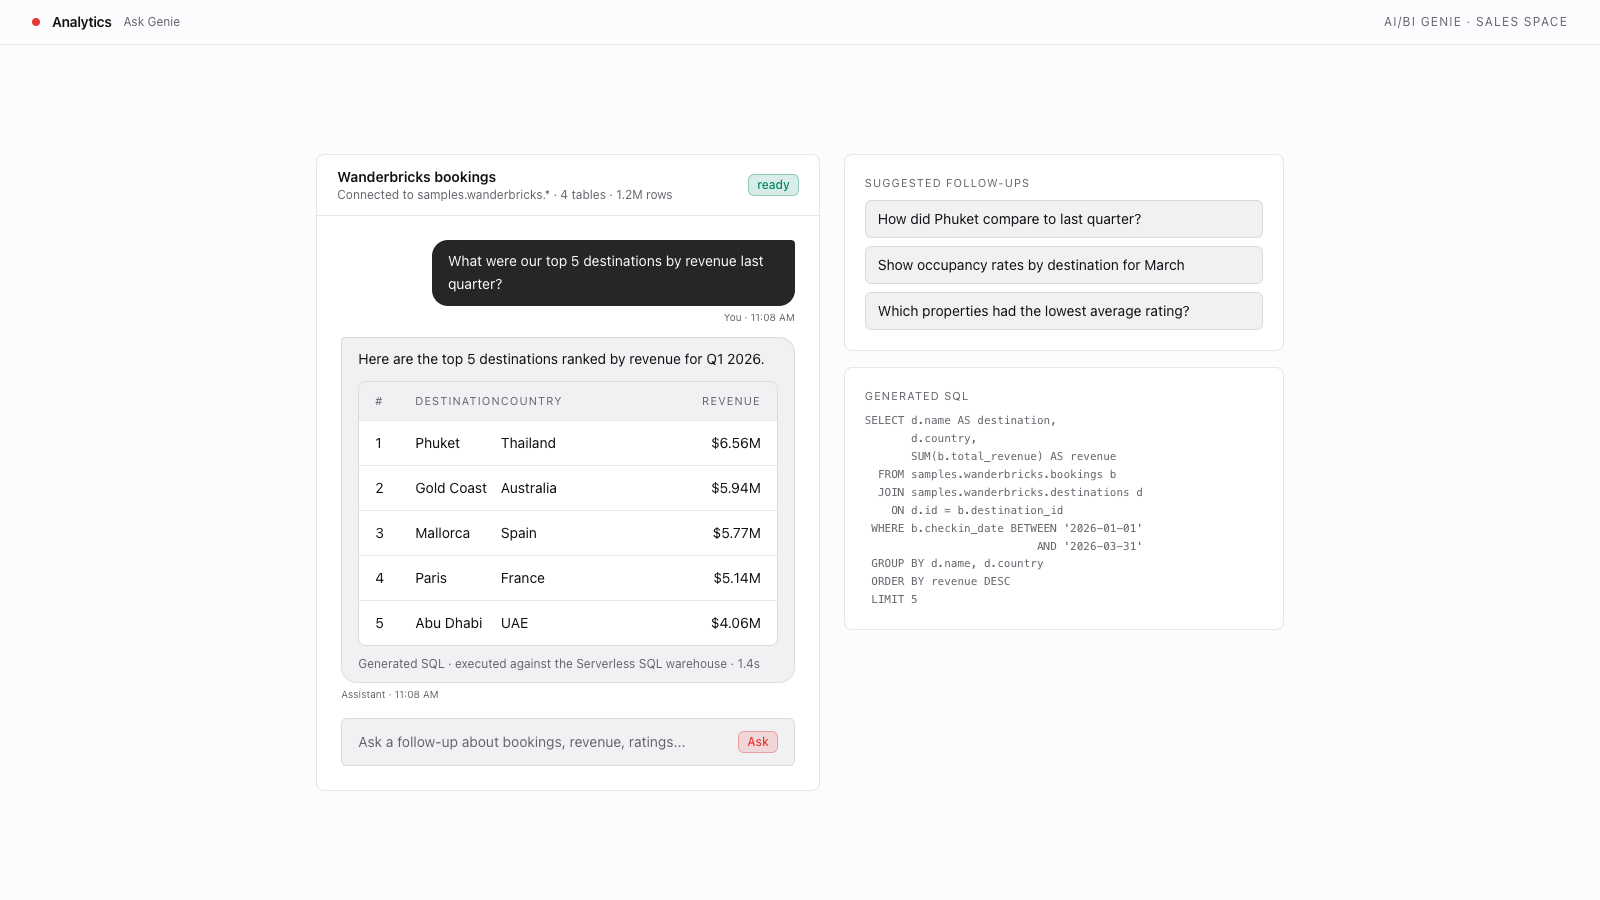
Intégrez une interface de chat Databricks AI/BI Genie afin que les utilisateurs puissent explorer les données en langage naturel. Configurez un Genie Agent, connectez les plugins serveur et client, déclarez les ressources de l’application et déployez.
[MODÈLES]
Interrogez les points de terminaison de modèles de fondation
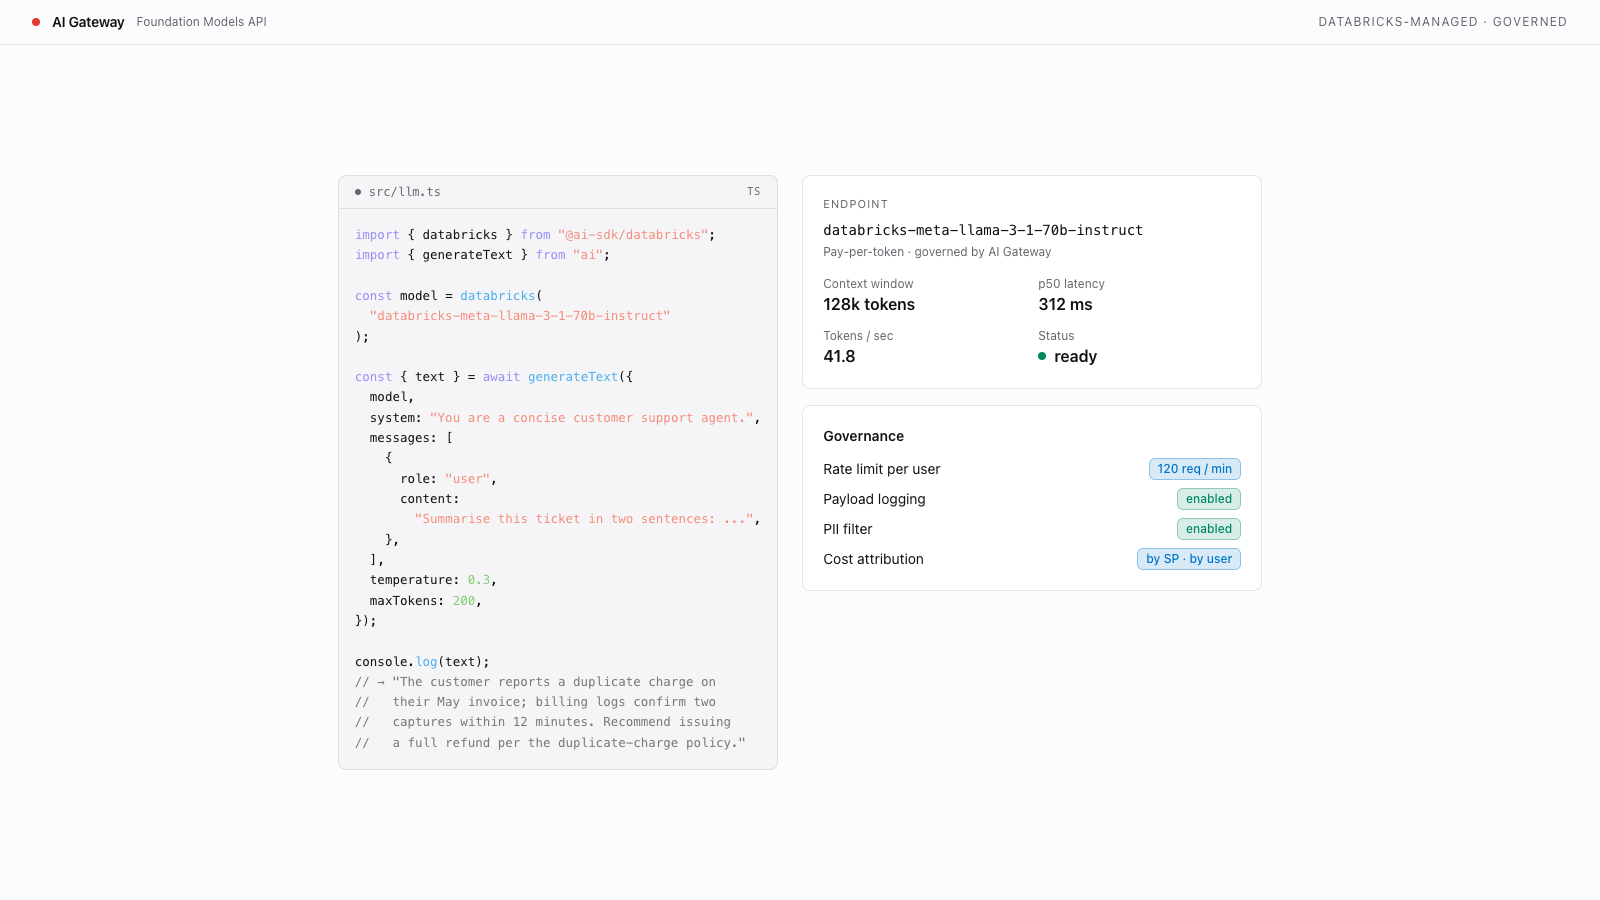
Interrogez les points de terminaison de modèles de fondation Databricks pour accéder en production à des modèles hébergés avec la gouvernance intégrée d’AI Gateway.