Gestion intelligente des stocks
Gestion des stocks de détail avec prévision de la demande optimisée par l’IA, recommandations de réapprovisionnement et analyses Genie facultatives. Basée sur un pipeline en médaillon en temps réel synchronisé avec Lakebase.
Créer avec l’IA
- Copiez le prompt ci-dessous
- Collez-le dans Cursor, Claude Code, Codex ou tout autre agent de codage
- Votre agent la crée en posant des questions au fil du processus afin que le résultat corresponde exactement à vos attentes
Vous découvrez les modèles ? En savoir plus ici
Inclut une application de démarrage fonctionnelle
Du code réel et exécutable est disponible sur GitHub. Lorsque vous copiez le prompt ci-dessus, votre agent de codage le clone comme point de départ et l’adapte à vos données et à votre cas d’utilisation.
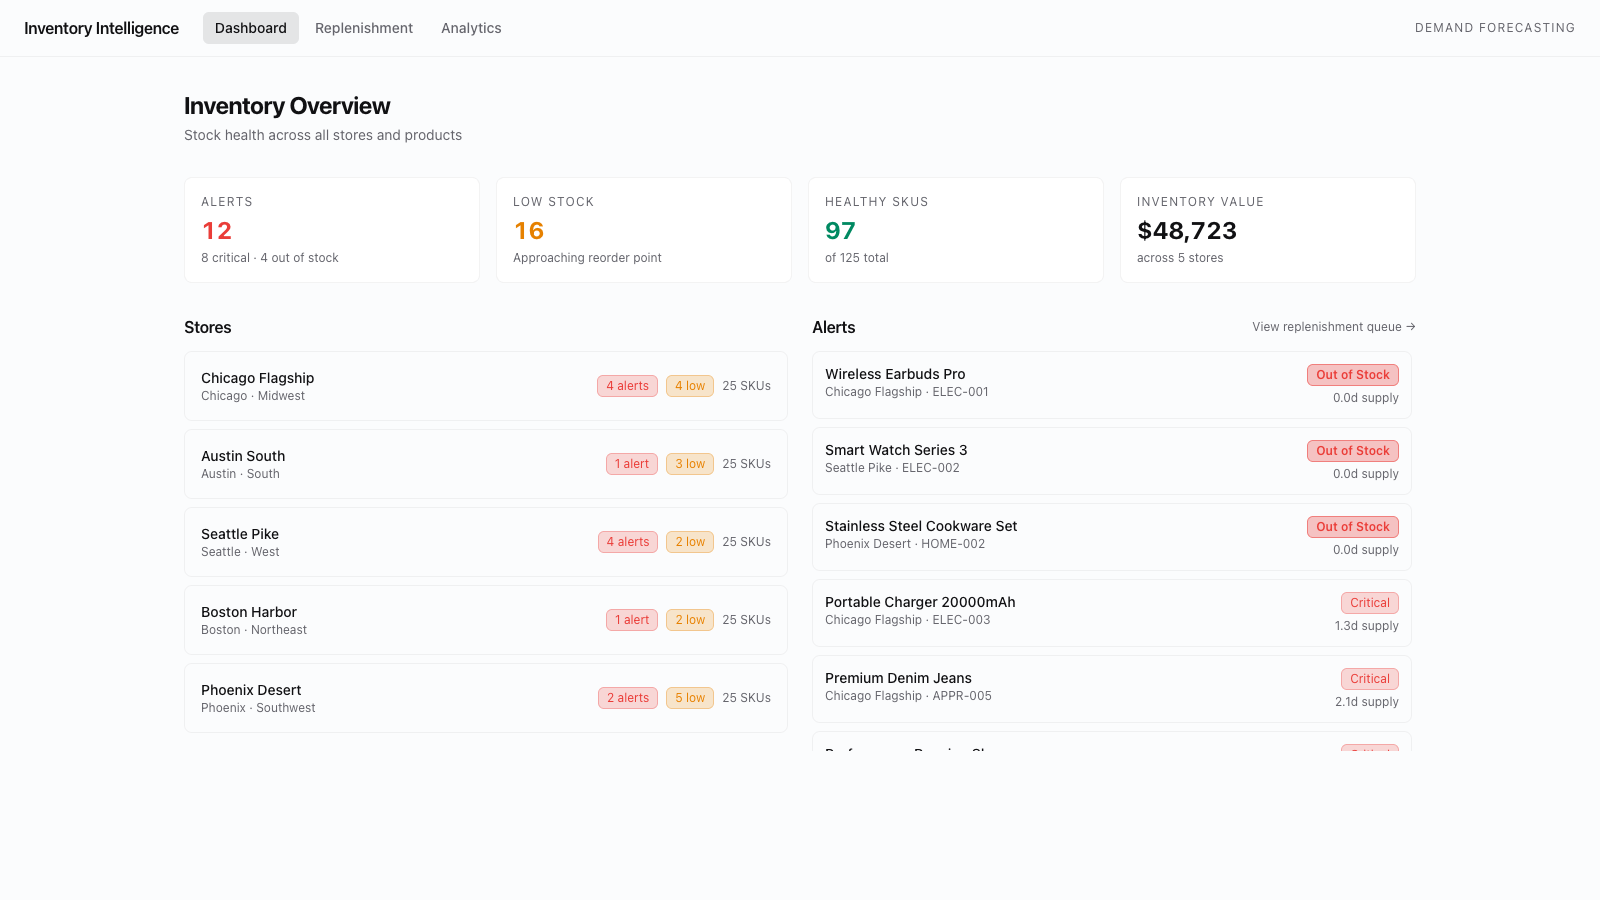
Ce modèle met en place un système complet de gestion des stocks pour le commerce de détail sur la stack Databricks : une application React où les responsables de magasin suivent l'état des stocks, examinent les recommandations de réapprovisionnement générées par l'IA et valident les bons de commande — le tout s'appuyant sur un pipeline medallion en temps réel et un job de prévision de la demande interchangeable.
Flux de données
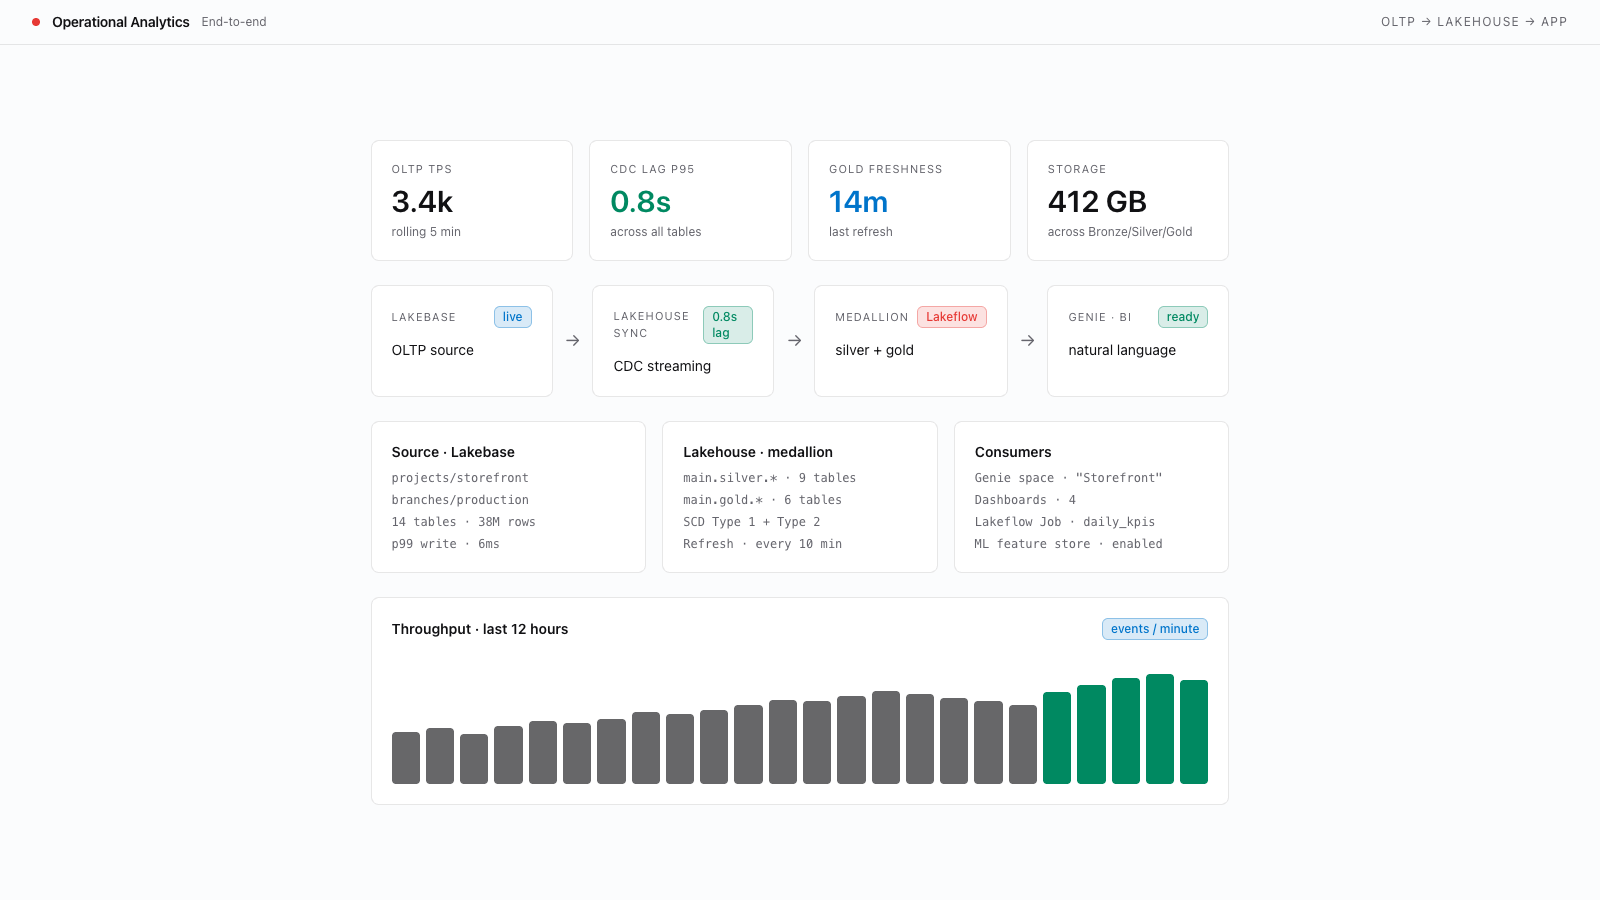
Les données de ventes et de stocks transitent de Lakebase Postgres vers le lakehouse, y sont enrichies par un modèle de prévision de la demande, puis renvoyées à l'application par synchronisation inverse :
- Les écritures OLTP arrivent dans Lakebase Postgres (magasins, produits, niveaux de stock, transactions de vente, commandes de réapprovisionnement).
- Le Change Data Feed (CDF) de Lakebase réplique chaque modification dans Unity Catalog sous forme de tables d'historique CDC (couche bronze).
- Un Lakeflow Spark Declarative Pipeline transforme l'historique CDC en tables silver reflétant l'état courant et en materialized views gold (vue d'ensemble des stocks, alertes de stock faible, vélocité des ventes).
- Un Lakeflow Job s'exécute selon une planification, charge l'historique des ventes silver et exécute un modèle de prévision de la demande enfichable pour produire des prévisions d'unités sur 30 jours et des recommandations de réapprovisionnement dans une table gold Delta.
- Les Tables de synchronisation (synchronisation inverse) répliquent les tables gold vers Lakebase pour des lectures à faible latence.
- L'Inventory Intelligence App (Databricks App) lit à la fois les tables OLTP et les tables gold synchronisées pour afficher des dashboards, des analyses détaillées par magasin, une file de réapprovisionnement et, en option, des analyses Genie.
Conception
L'application doit offrir un design soigné et élégant — typographie épurée, espacements cohérents et esthétique professionnelle propre au commerce de détail. Appuyez-vous sur les composants shadcn/ui comme fondation, sur Tailwind pour l'ensemble du style et sur les couleurs de la marque dans toute l'application. Les tableaux de bord doivent paraître riches en données sans être surchargés, et la file de réapprovisionnement doit rendre les flux de travail d'approbation parfaitement fluides.
Ce qu'il faut adapter
Le provisionnement (schémas Unity Catalog, REPLICA IDENTITY Lakebase), l'amorçage des données, les déploiements de pipelines, la synchronisation inverse et le déploiement de l'application sont documentés dans le fichier README.md du dépôt, aux côtés du code.
Pour adapter ce modèle à vos besoins :
- Catalogue : définissez la variable
catalogdans ledatabricks.ymlde chaque pipeline avec le nom de votre catalogue Unity Catalog. - Lakebase : faites pointer le
databricks.ymlde l'application vers vos propres projet, branch et base de données Lakebase. - Tables : le script d'amorçage crée le schéma OLTP avec 5 magasins, 25 produits et 90 jours d'historique de ventes. Une fois les données amorcées, configurez le Change Data Feed pour répliquer les tables du schéma
inventory. - Tables de synchronisation : créez manuellement les trois configurations de synchronisation inverse (consultez le README pour les correspondances exactes entre tables).
- Modèle de prévision : définissez la variable
forecast_modeldu pipeline de prévision de la demande surweighted_moving_average(valeur par défaut),exponential_smoothing,prophetoumodel_serving. - Genie Agent : créez un Genie Agent sur vos tables gold et définissez
genie_space_iddans le bundle de l'application pour activer l'onglet Analytics.
Basé sur ces modèles
Le code de cet exemple et le prompt de l’agent ci-dessus s’appuient tous deux sur les modèles ci-dessous. Ouvrez-en un pour découvrir une technique précise ou l’appliquer à un autre projet.
[MODÈLES]
Analyse des données opérationnelles
Configuration de bout en bout pour analyser les données de bases de données opérationnelles dans le Lakehouse : Unity Catalog avec stockage externe, provisionnement de Lakebase, réplication via Lakebase Change Data Feed (CDF) et pipeline d’architecture en médaillon avec couches silver et gold.

[MODÈLES]
Application avec Lakebase
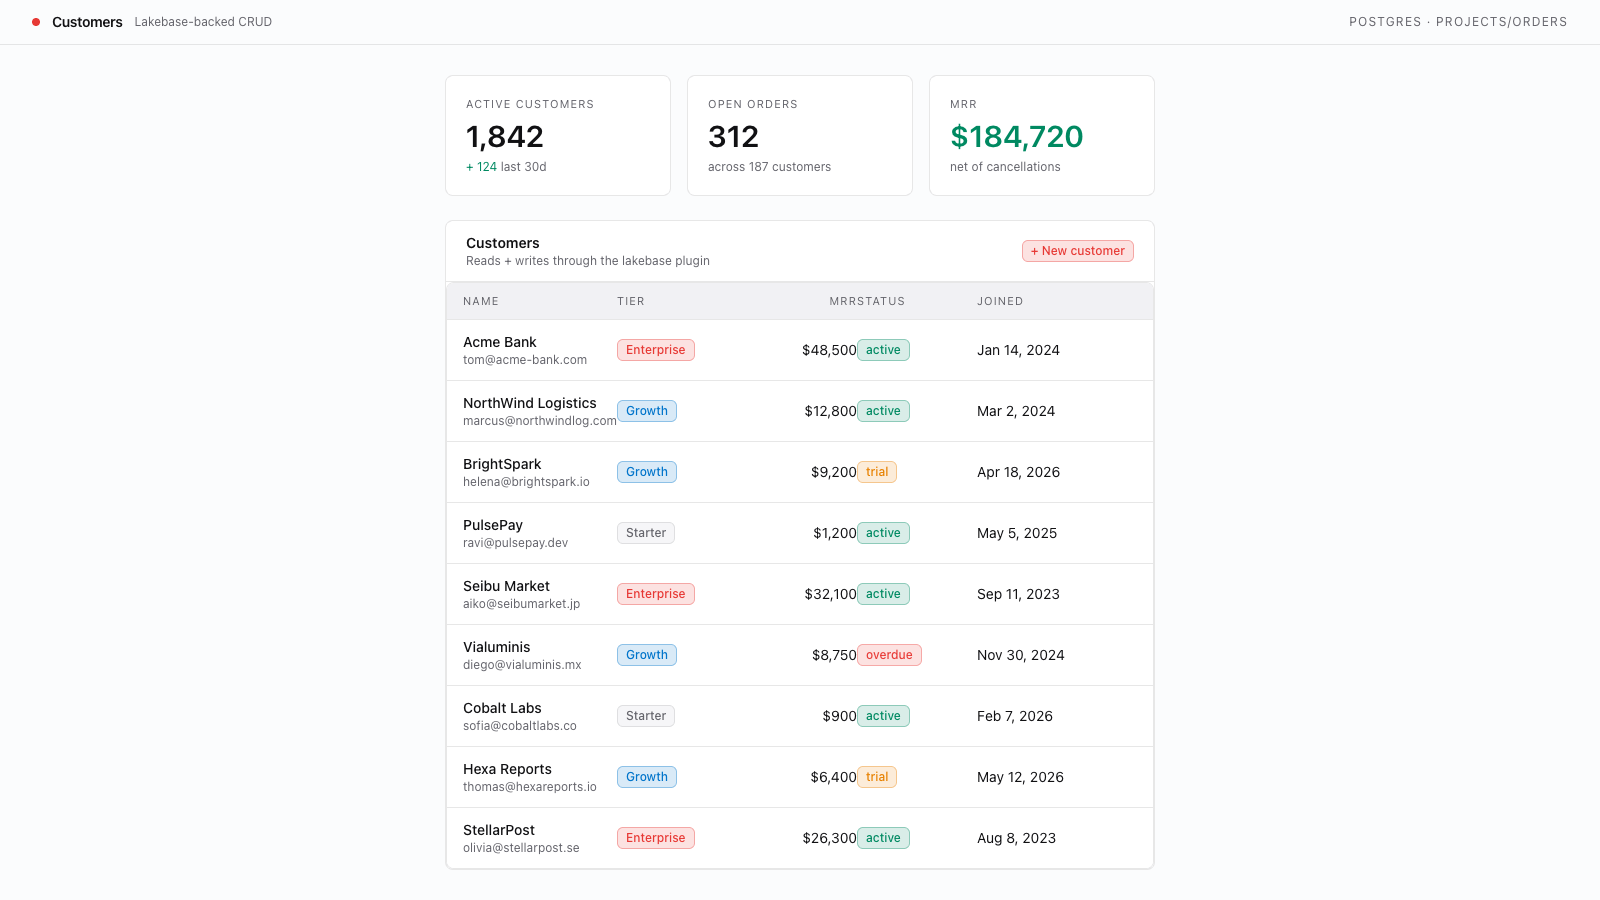
Connectez une Databricks App à Lakebase pour assurer un stockage persistant des données. Inclut la configuration du schéma et des routes d’API CRUD complètes.
[MODÈLES]
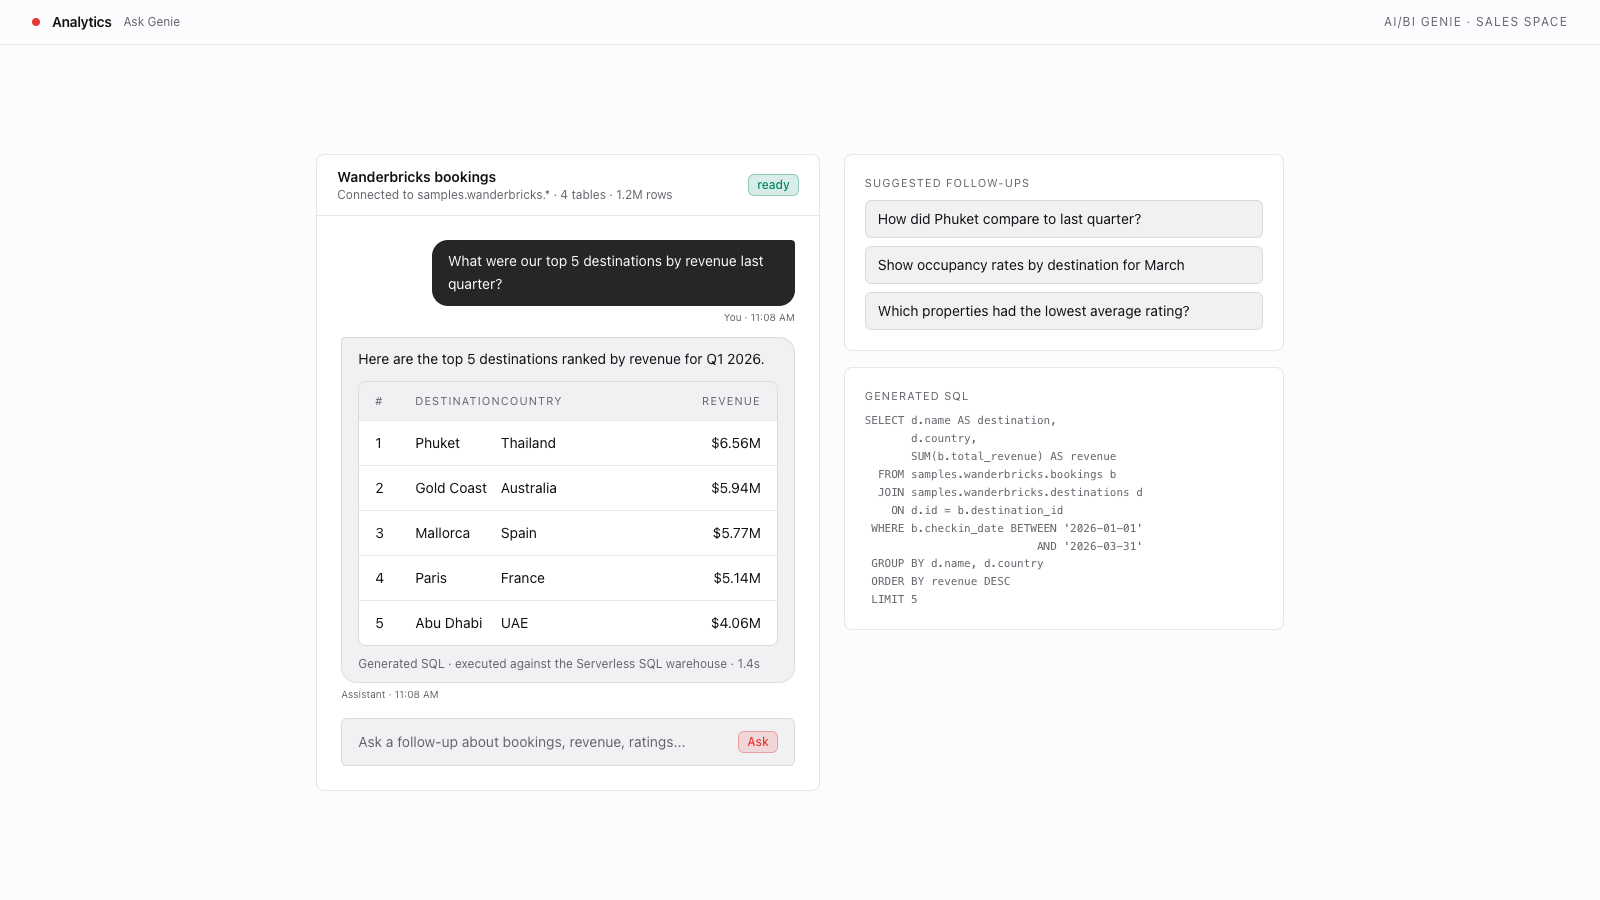
Analytique conversationnelle Genie
Intégrez une interface de chat Databricks AI/BI Genie afin que les utilisateurs puissent explorer les données en langage naturel. Configurez un Genie Agent, connectez les plugins serveur et client, déclarez les ressources de l’application et déployez.