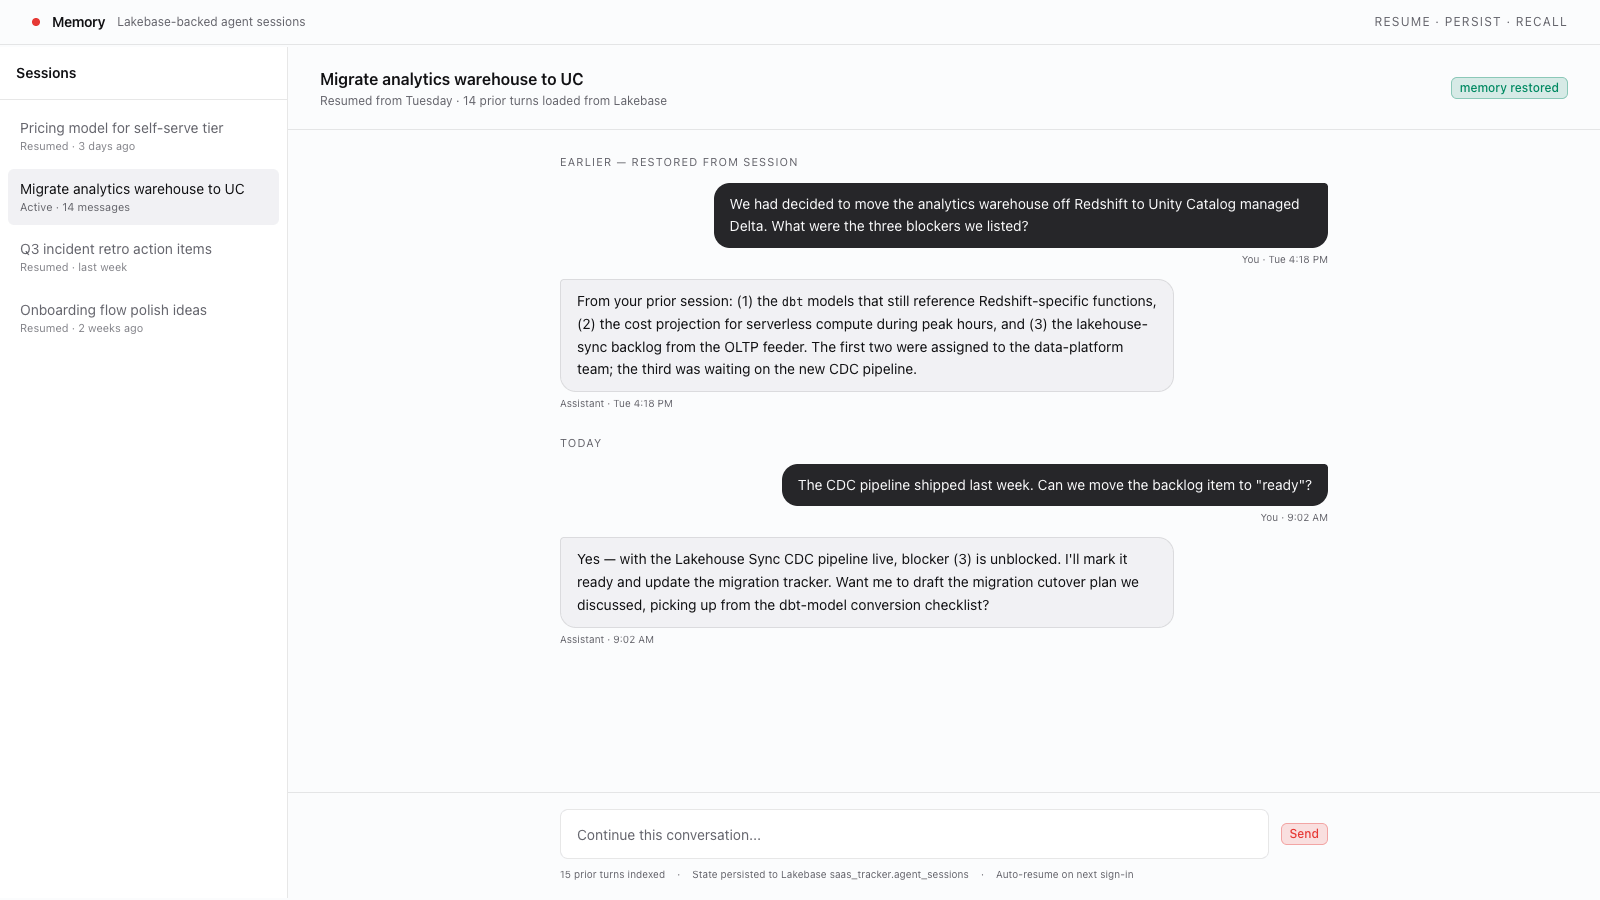
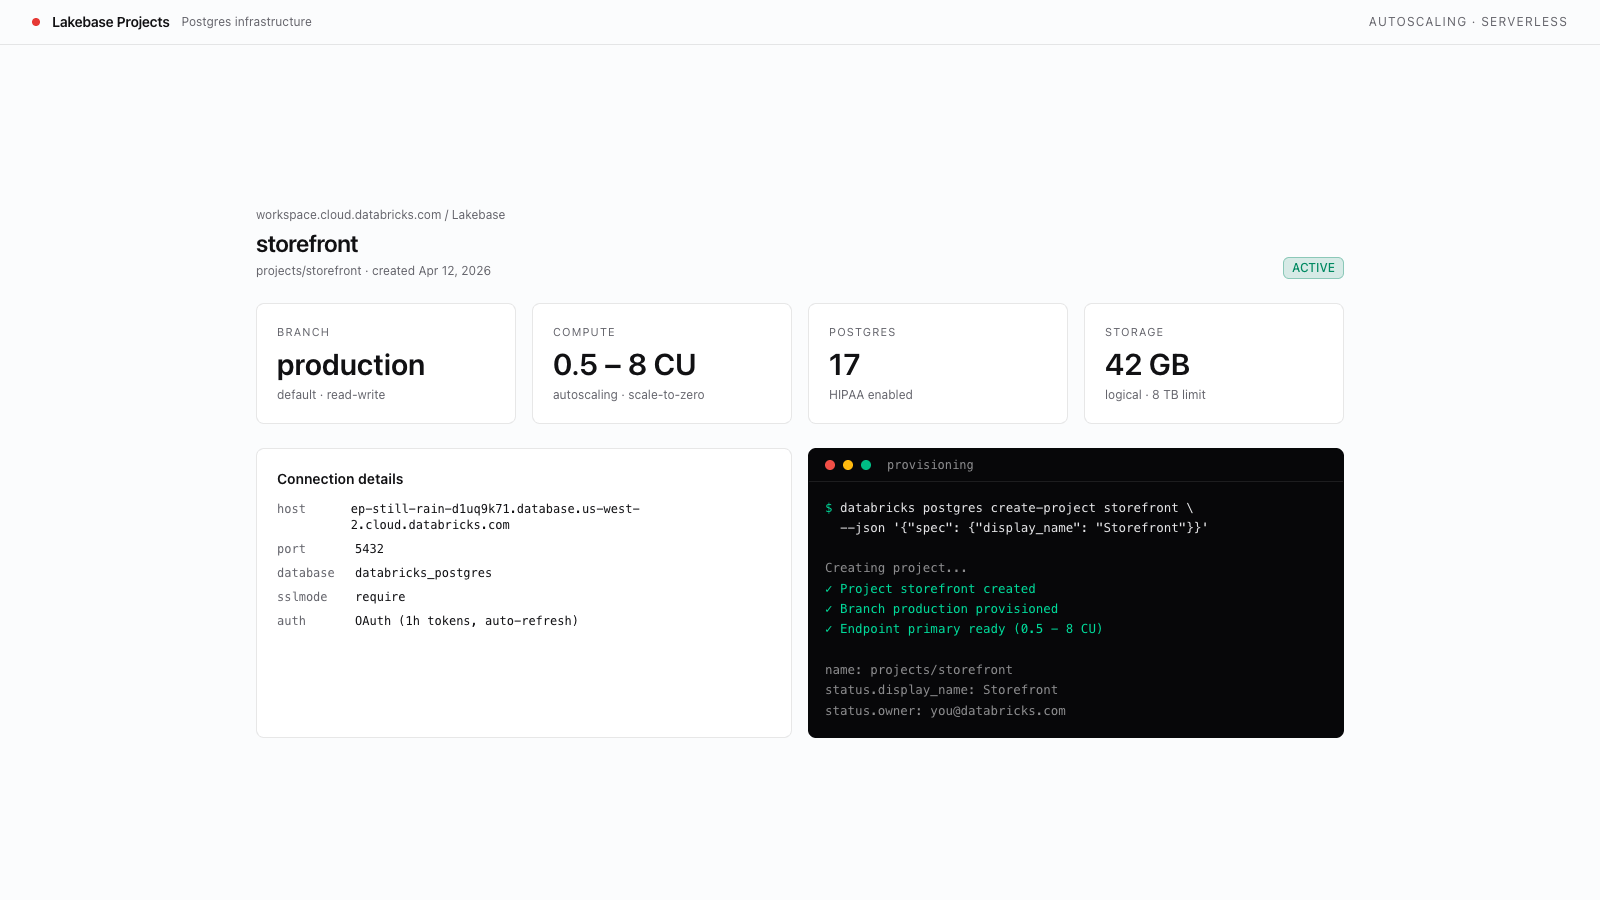
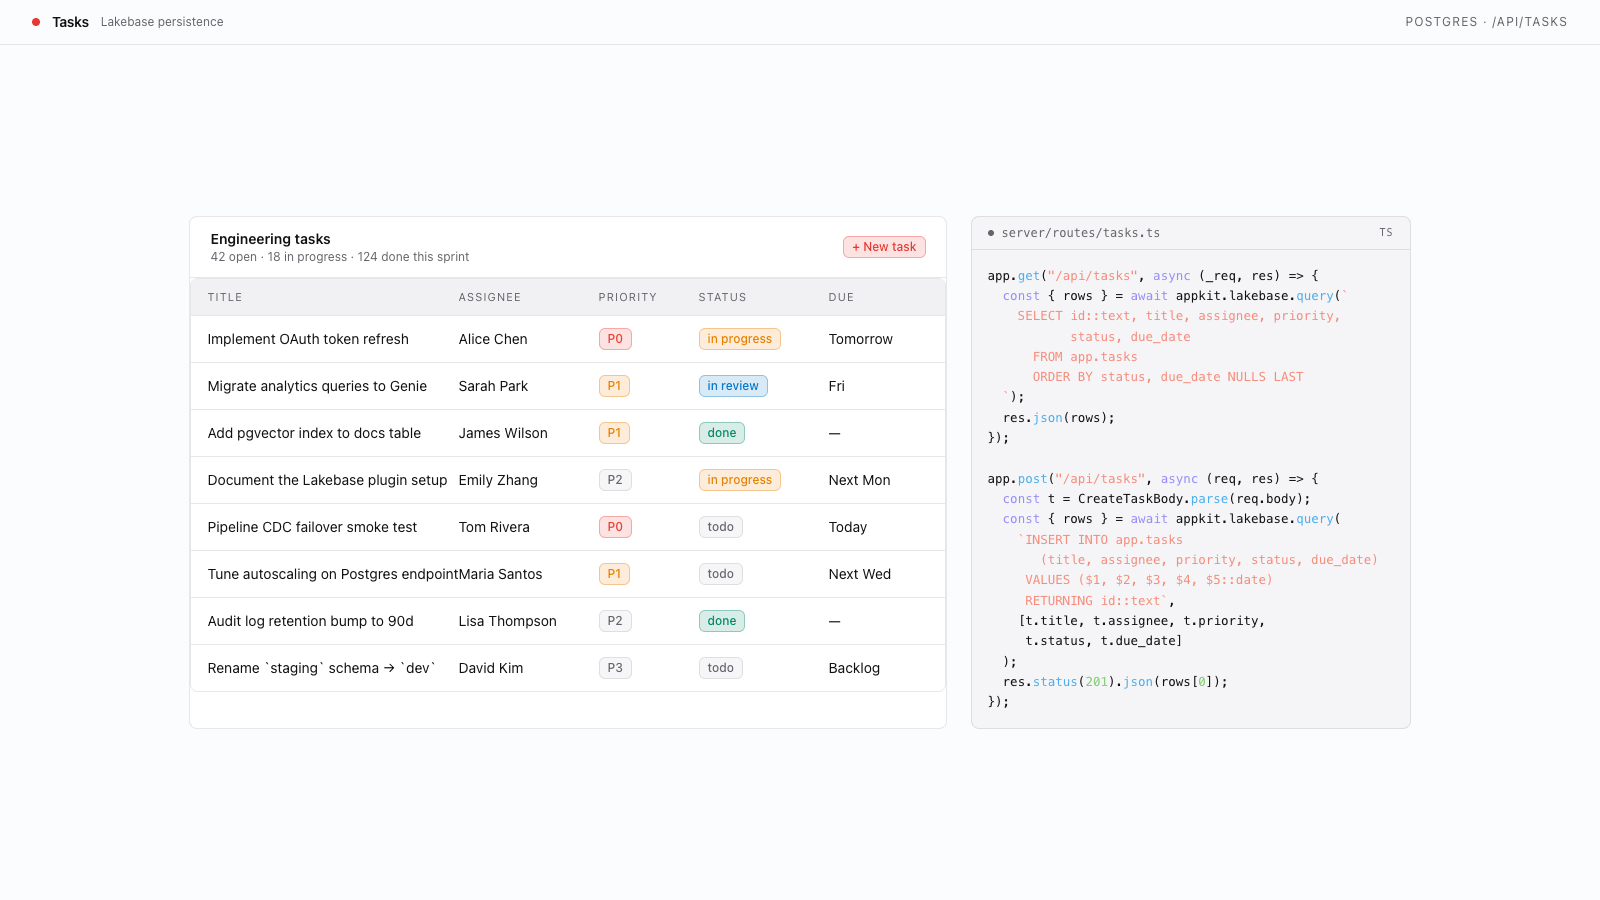
Lakebase pgvector
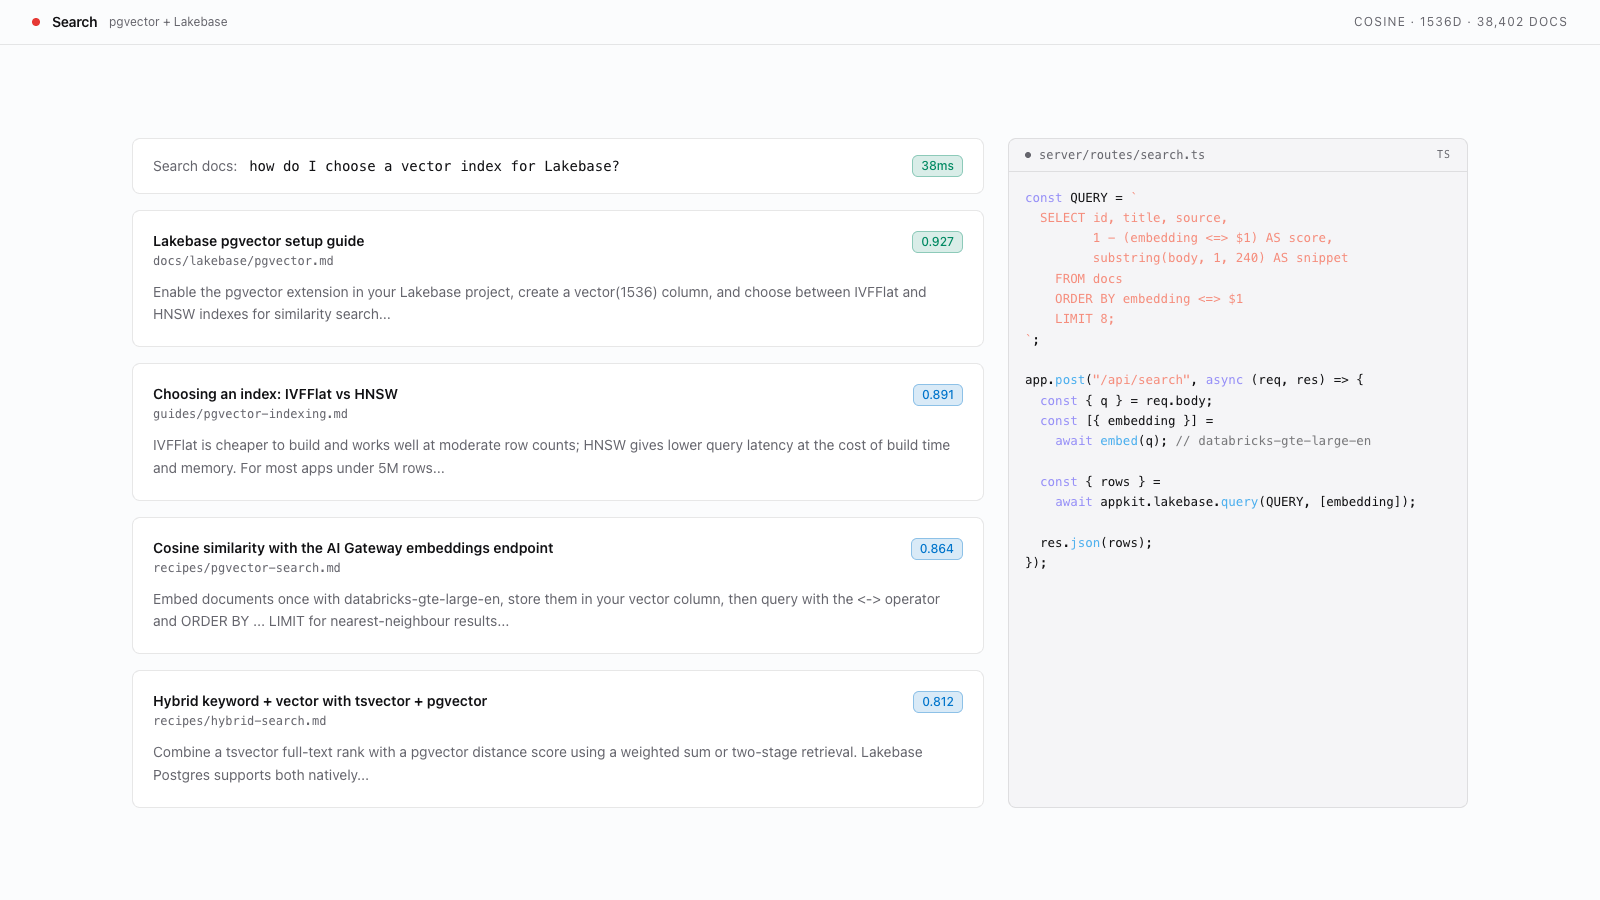
Activez la recherche de similarité vectorielle dans Lakebase à l’aide de l’extension pgvector. Couvre la configuration de l’extension, la conception des tables vectorielles, les fonctions utilitaires d’insertion et de recherche par similarité cosinus, ainsi que les options d’index IVFFlat/HNSW.
Créer avec l’IA
- Copiez le prompt ci-dessous
- Collez-le dans Cursor, Claude Code, Codex ou tout autre agent de codage
- Votre agent la crée en posant des questions au fil du processus afin que le résultat corresponde exactement à vos attentes
Vous découvrez les modèles ? En savoir plus ici
Au terme de ce guide, vous disposerez de :
- L'extension pgvector activée sur votre instance Lakebase
- Une table d'embeddings vectoriels aux dimensions configurables
- Des fonctions côté serveur pour insérer des documents et effectuer des recherches par similarité
- Un index IVFFlat ou HNSW pour des requêtes de plus proches voisins performantes
Prerequisites
Vérifiez que ces fonctionnalités du workspace Databricks sont activées avant de commencer. Si l'une des vérifications échoue, demandez à l'administrateur de votre workspace d'activer la fonctionnalité concernée.
- Lakebase Postgres disponible. Exécutez
databricks postgres list-projects --profile <PROFILE>et vérifiez que la commande aboutit. Une erreurnot enabledsignifie que Lakebase n'est pas disponible pour cette identité. - Un projet Lakebase provisionné. Suivez d'abord le modèle Créer un projet Lakebase. Vous activerez l'extension
vectorsur son endpoint principal. databricks psqldisponible dans votre CLI. Exécutezdatabricks psql --helpet vérifiez que la sous-commande existe. Si ce n'est pas le cas, mettez à jour la CLI Databricks (voir Configurer votre environnement de développement local).