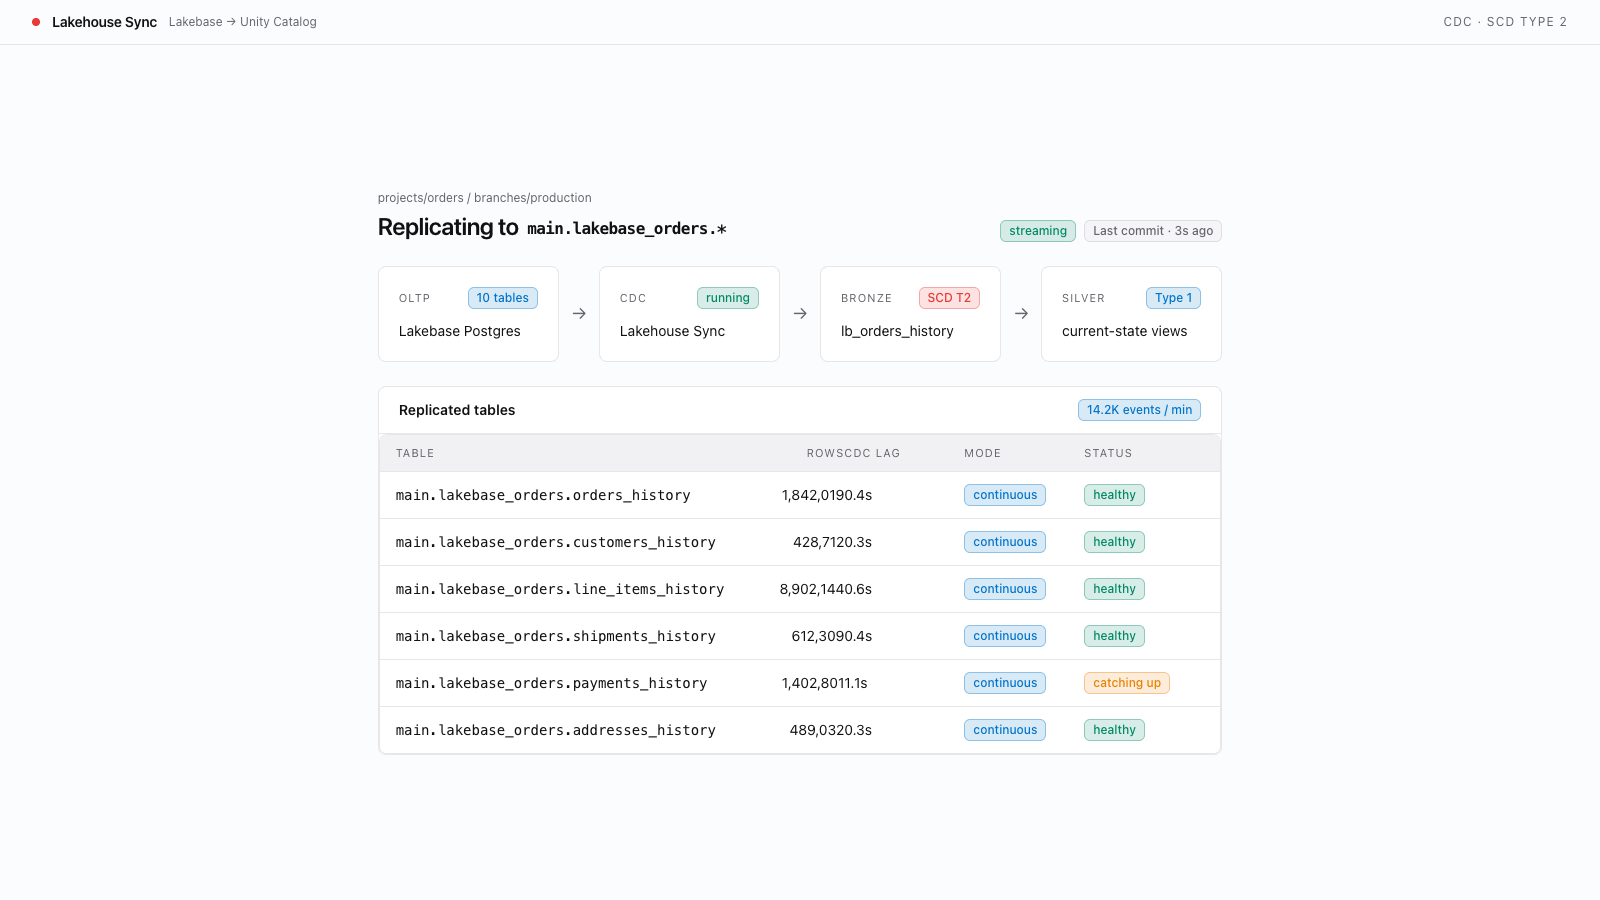
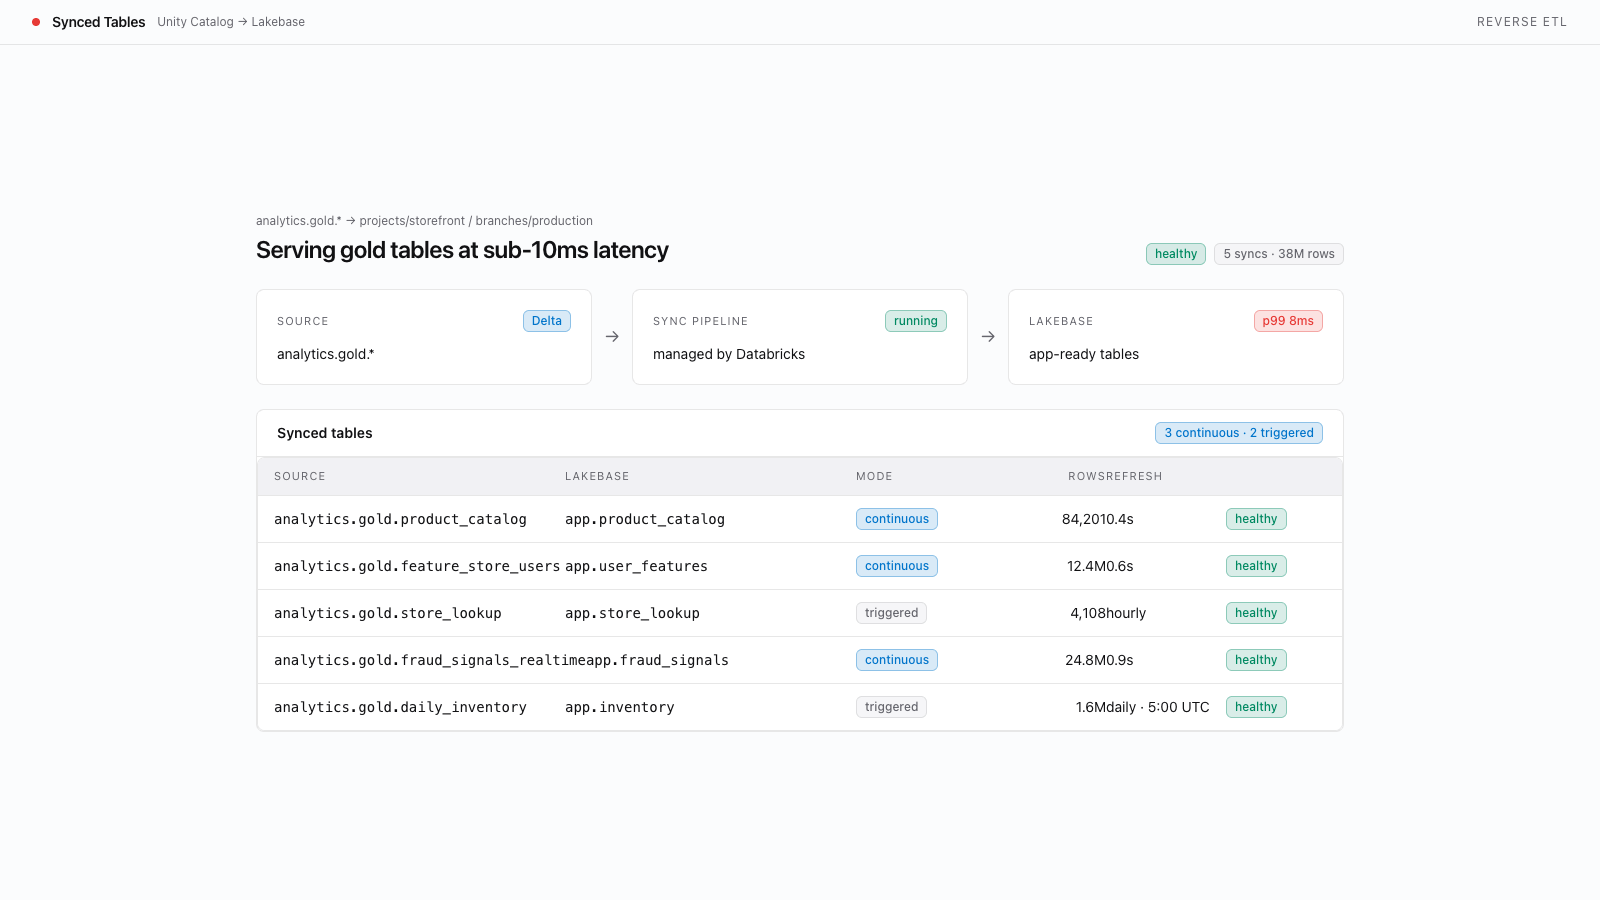
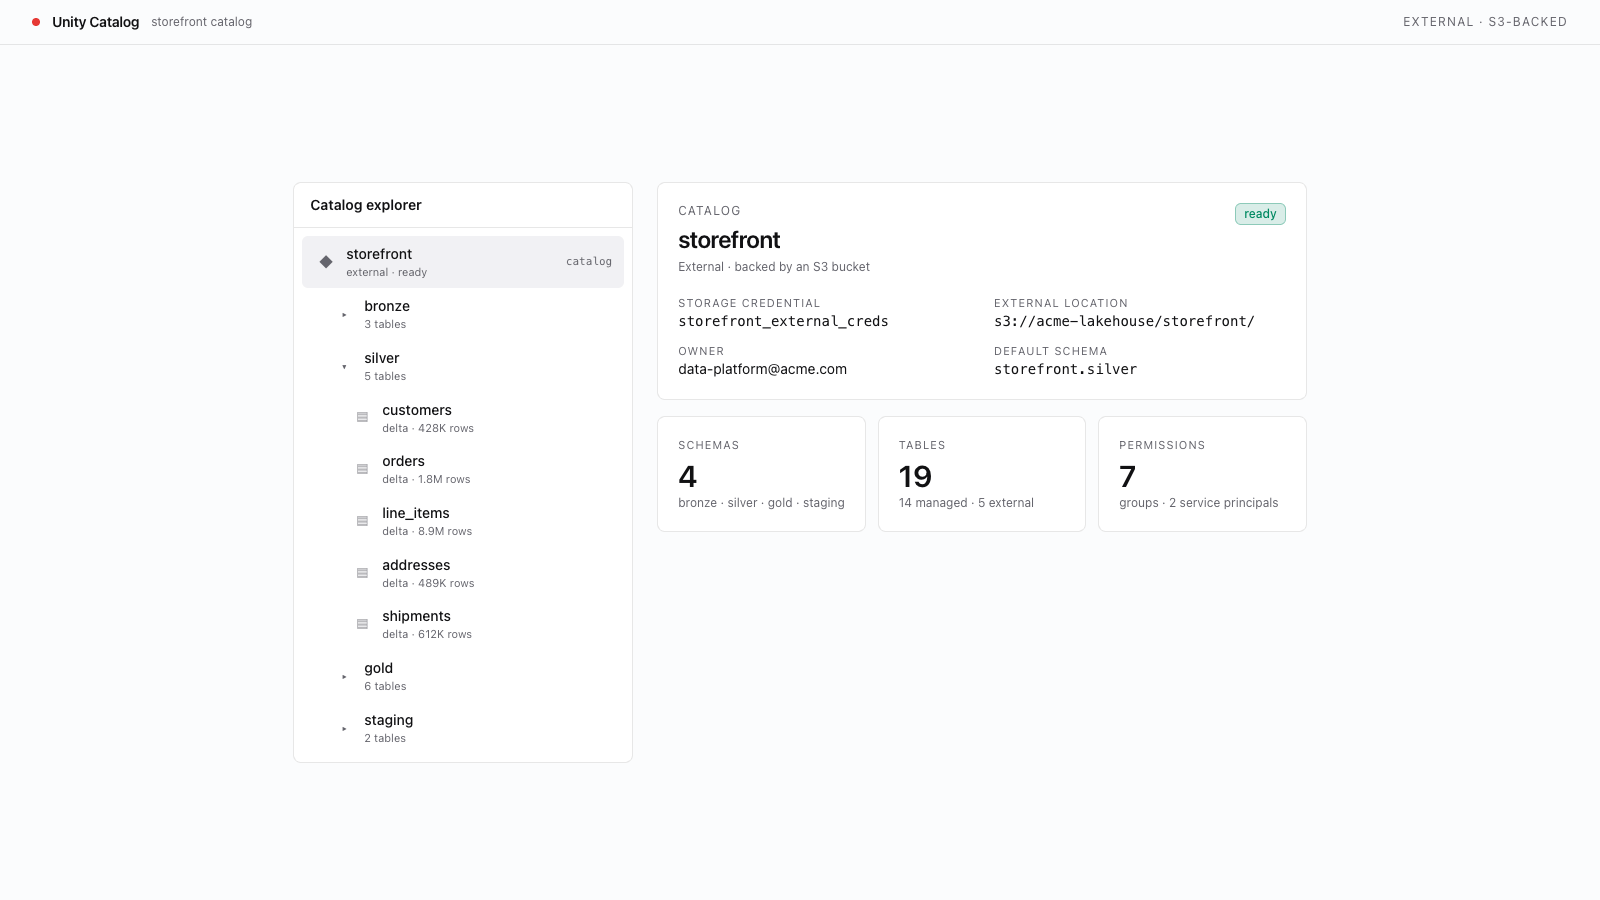
Architecture en médaillon à partir de tables d’historique CDC
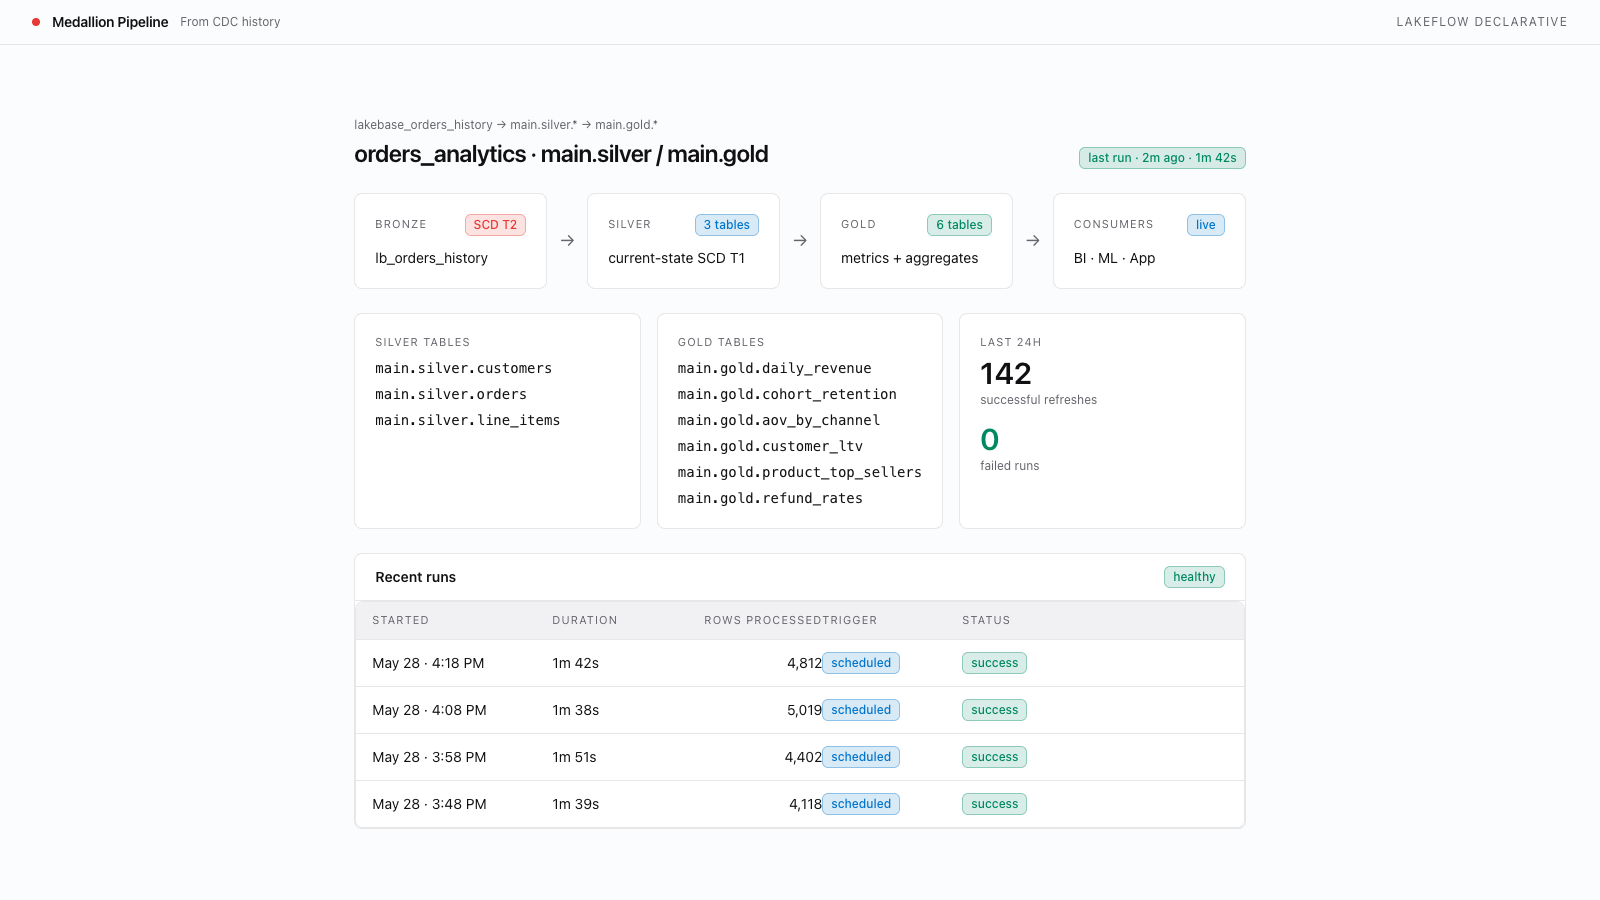
Transformez les tables d’historique Lakebase Change Data Feed en une architecture en médaillon avec des couches silver (état actuel) et gold (agrégations) à l’aide de Lakeflow Spark Declarative Pipelines.
Créer avec l’IA
- Copiez le prompt ci-dessous
- Collez-le dans Cursor, Claude Code, Codex ou tout autre agent de codage
- Votre agent la crée en posant des questions au fil du processus afin que le résultat corresponde exactement à vos attentes
Vous découvrez les modèles ? En savoir plus ici
Une fois l'opération terminée, vous disposerez de :
- Une couche bronze fournie par les tables d'historique Change Data Feed de Lakebase en amont (entrée de cette recette)
- Une couche argent avec des vues matérialisées dédupliquées reflétant l'état courant de chaque entité
- Une couche or avec des agrégations et des métriques métier sous forme de vues matérialisées
- Un Lakeflow Spark Declarative Pipeline planifié qui actualise les couches argent et or de manière incrémentielle
- Toutes les couches interrogeables en tant que tables Unity Catalog via SQL, Spark, les outils de BI et Genie
Prerequisites
Ce modèle construit un Lakeflow Spark Declarative Pipeline s'appuyant sur des tables d'historique Lakebase Change Data Feed (CDF) existantes. Vérifiez que ces fonctionnalités du workspace Databricks sont activées avant de commencer.
- Lakeflow Spark Declarative Pipelines (sans serveur) disponibles. Exécutez
databricks pipelines list-pipelines --profile <PROFILE>et vérifiez que la commande aboutit (une liste vide est normale). Une erreur de permission ounot enabledsignifie que Lakeflow Pipelines n'est pas disponible pour cette identité. - Accès à Unity Catalog avec un schema de destination accessible en écriture. Exécutez
databricks catalogs list --profile <PROFILE>et vérifiez que votre catalogue de destination figure dans la liste. Vous aurez besoin deUSE_CATALOGsur le catalogue ainsi que deUSE_SCHEMA+CREATE_MATERIALIZED_VIEWsur le schema de destination pour publier les materialized views silver et gold (et deCREATE_TABLEsi le pipeline crée également des tables en streaming). - Tables d'historique CDC bronze déjà présentes dans Unity Catalog. Suivez d'abord le modèle Lakebase Change Data Feed (Autoscaling) afin que les tables
lb_<entity>_historyexistent dans le schema bronze. Ce modèle lit ces tables ; il ne les crée pas.