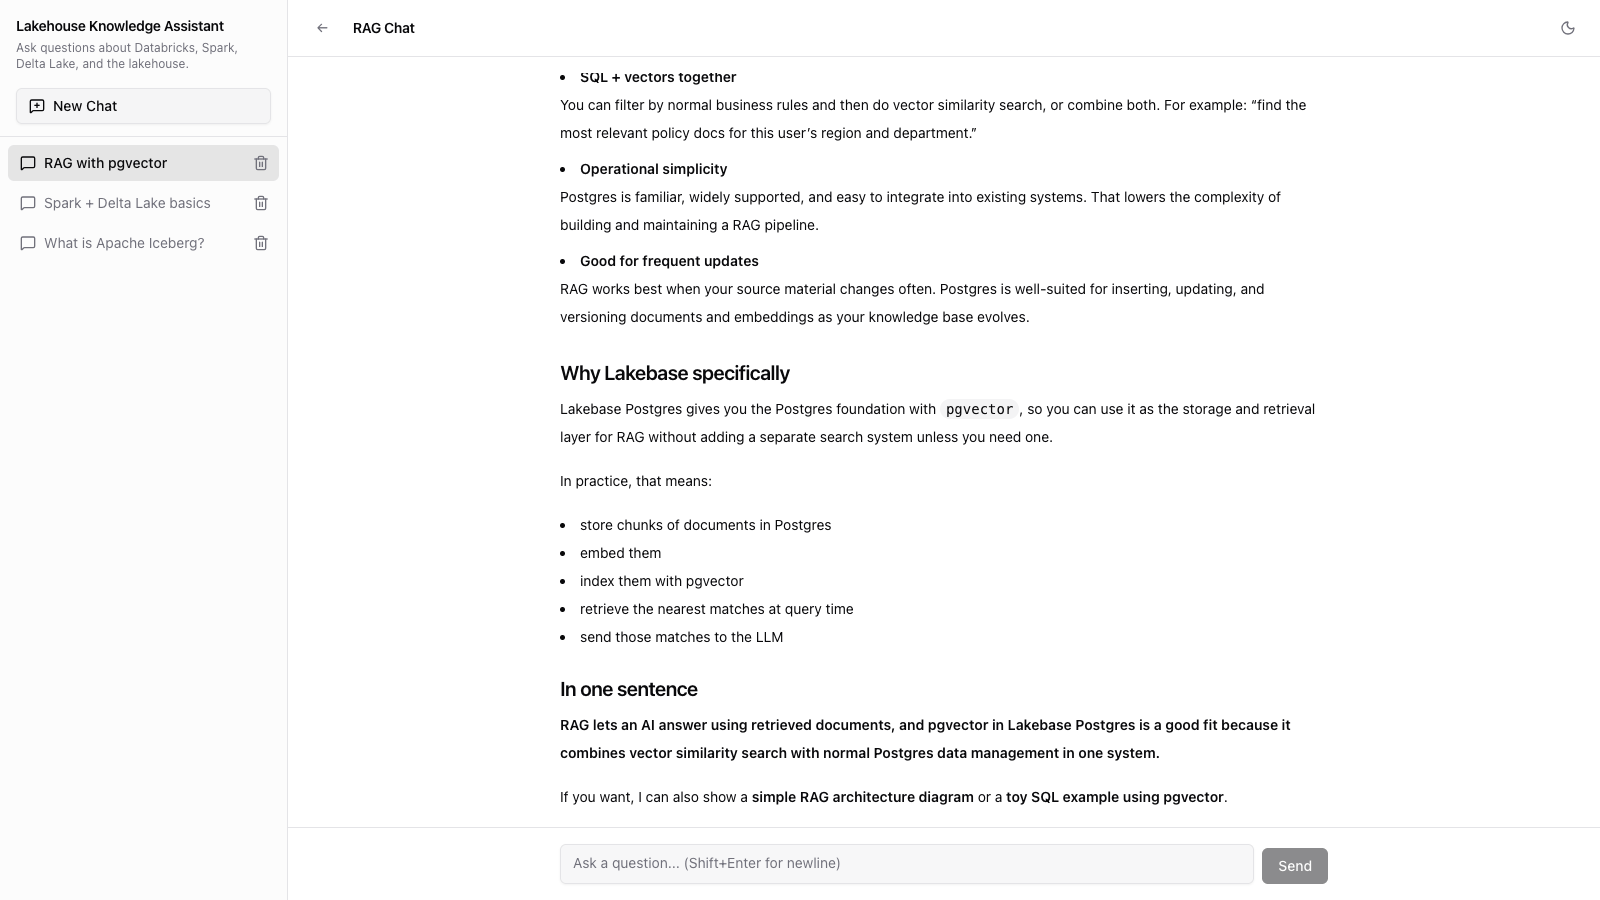
Application de chat RAG
Application de chat de génération augmentée par récupération en streaming, avec récupération pgvector depuis Lakebase, corpus initial issu de Wikipedia, génération via Model Serving et historique de chat stocké dans Lakebase. Utilisée via `databricks apps init`.
Créer avec l’IA
- Copiez le prompt ci-dessous
- Collez-le dans Cursor, Claude Code, Codex ou tout autre agent de codage
- Votre agent la crée en posant des questions au fil du processus afin que le résultat corresponde exactement à vos attentes
Vous découvrez les modèles ? En savoir plus ici
Inclut une application de démarrage fonctionnelle
Du code réel et exécutable est disponible sur GitHub. Lorsque vous copiez le prompt ci-dessus, votre agent de codage le clone comme point de départ et l’adapte à vos données et à votre cas d’utilisation.
Ce modèle illustre une application de chat à génération augmentée par récupération (RAG) construite sur Databricks : la question de l'utilisateur est convertie en embedding, les documents similaires sont récupérés depuis un magasin pgvector dans Lakebase Postgres, puis le contexte ainsi obtenu est injecté dans un appel Model Serving qui renvoie la réponse en streaming. Les conversations et les sources sont conservées pour chaque chat dans Lakebase.
Flux de données
L'ensemble de l'état de récupération et de conversation réside dans Lakebase Postgres ; la génération s'appuie sur Model Serving :
- L'amorçage récupère quelques articles Wikipédia au démarrage, les découpe en fragments par paragraphe, encode chaque fragment via l'endpoint d'embeddings du modèle de fondation (
databricks-gte-large-enpar défaut), puis écrit les lignes dansrag.documentsavec une colonnevector(1024). - Les tours utilisateur sont encodés avec le même endpoint. Le serveur exécute une recherche par similarité cosinus pgvector afin de récupérer les k fragments les plus pertinents.
- Injection du contexte : les fragments récupérés sont placés en tête sous forme de message système, avant l'envoi de l'historique de conversation de l'utilisateur à l'endpoint de complétion de chat (
databricks-gpt-5-4-minipar défaut) via Model Serving. - Streaming :
streamTextdiffuse les tokens vers le client tandis qu'un callbackonFinishajoute le tour de l'assistant dans Lakebase. - Historique de conversation : chaque tour utilisateur et assistant est conservé dans
chat.messages, indexé parchat_id, ce qui permet de reprendre les conversations.
Approche du modèle
Contrairement aux autres modèles, ce modèle est conçu pour être utilisé via databricks apps init, et non git clone. Le flux d'initialisation :
- Demande les noms de la branch Lakebase Postgres et de la ressource de base de données.
- Résout automatiquement
PGHOST,PGDATABASEetLAKEBASE_ENDPOINTdans votre fichier.envlocal en appelant les API Lakebase. - Écrit
DATABRICKS_CONFIG_PROFILEouDATABRICKS_HOSTselon votre configuration de la CLI Databricks. - Vous place directement dans un répertoire de projet prêt à l'emploi, nommé d'après
--name.
Cela valide le système de modèles AppKit comme moyen de déployer des modèles DevHub — voyez appkit.plugins.json et .env.tmpl dans le modèle pour en comprendre le fonctionnement.
Ce qu'il faut adapter
La configuration et le provisionnement sont documentés dans le fichier README.md du dépôt.
Pour adapter ce modèle à vos besoins :
- Lakebase : faites pointer le bundle vers vos propres project, branch et base de données Lakebase (demandés lors de l'initialisation).
- Model Serving endpoint : redéfinissez
DATABRICKS_ENDPOINTpour utiliser un autre modèle de chat (par exempledatabricks-claude-sonnet-4-6). - Endpoint d'embeddings : redéfinissez
DATABRICKS_EMBEDDING_ENDPOINTsi vous souhaitez un autre modèle d'embedding. Assurez-vous que la dimensionvector(N)dansserver/lib/rag-store.tscorresponde. - Données d'amorçage : remplacez la liste d'articles Wikipedia dans
server/lib/seed-data.tspar votre propre corpus. La fonction de découpage sépare le texte aux limites de paragraphe — adaptez-la si votre source a une structure différente. - Récupération : par défaut, le top-k est de 5 et la métrique de similarité est le cosinus. Ajustez ces paramètres dans
retrieveSimilar().
Basé sur ces modèles
Le code de cet exemple et le prompt de l’agent ci-dessus s’appuient tous deux sur les modèles ci-dessous. Ouvrez-en un pour découvrir une technique précise ou l’appliquer à un autre projet.
[MODÈLES]
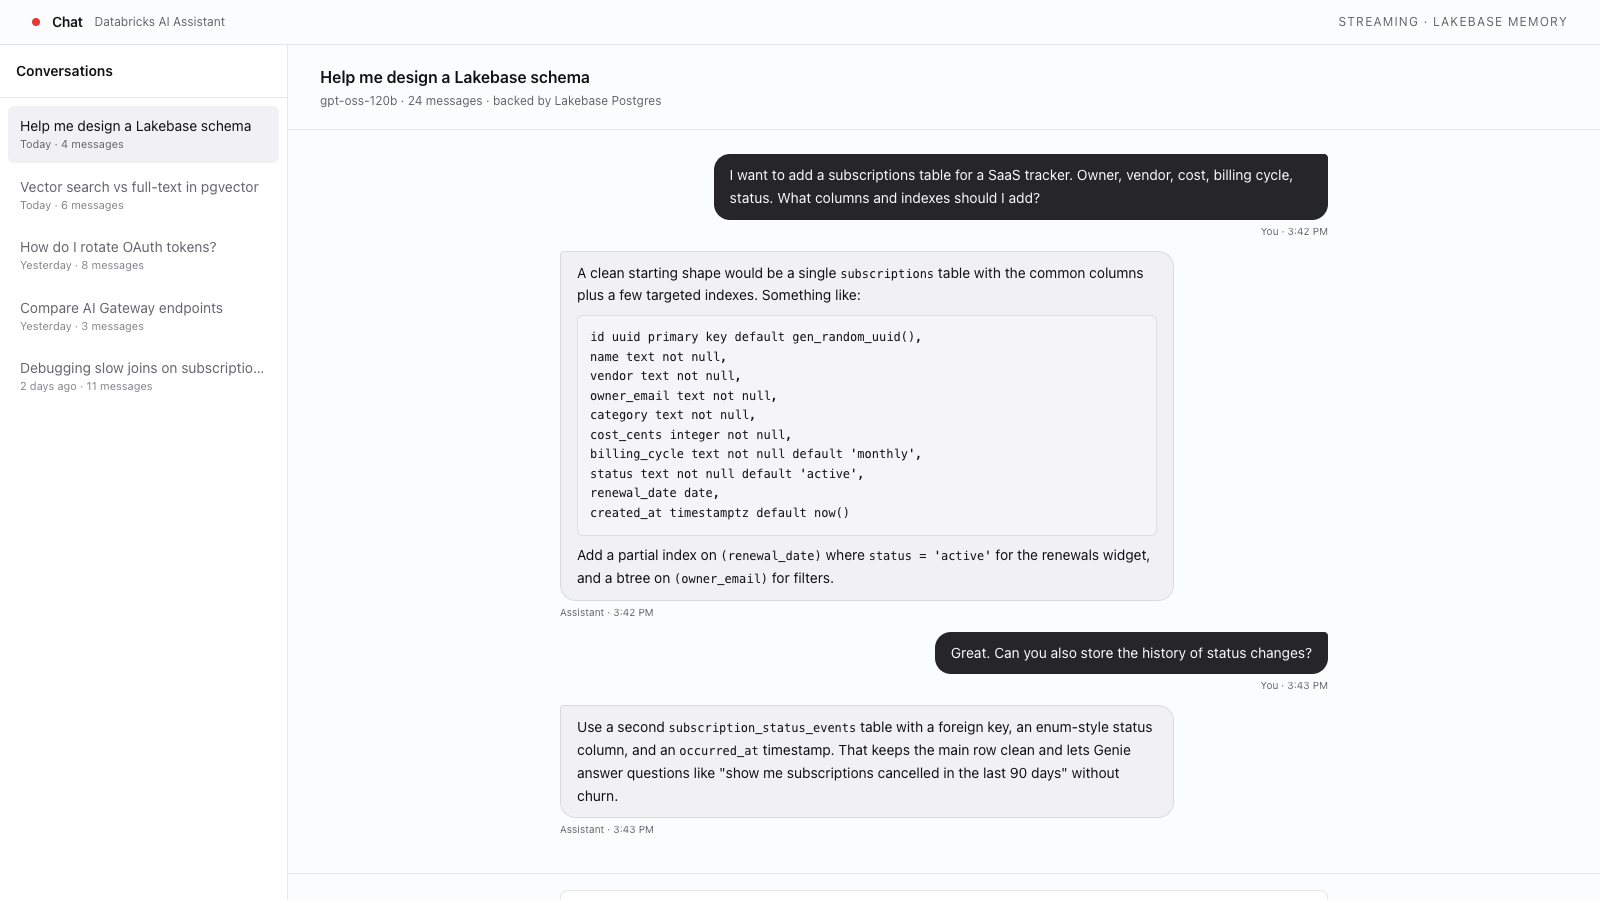
Application de chat IA
Intégration de Model Serving, chat en streaming avec AI SDK et historique de chat conservé dans Lakebase.

[MODÈLES]
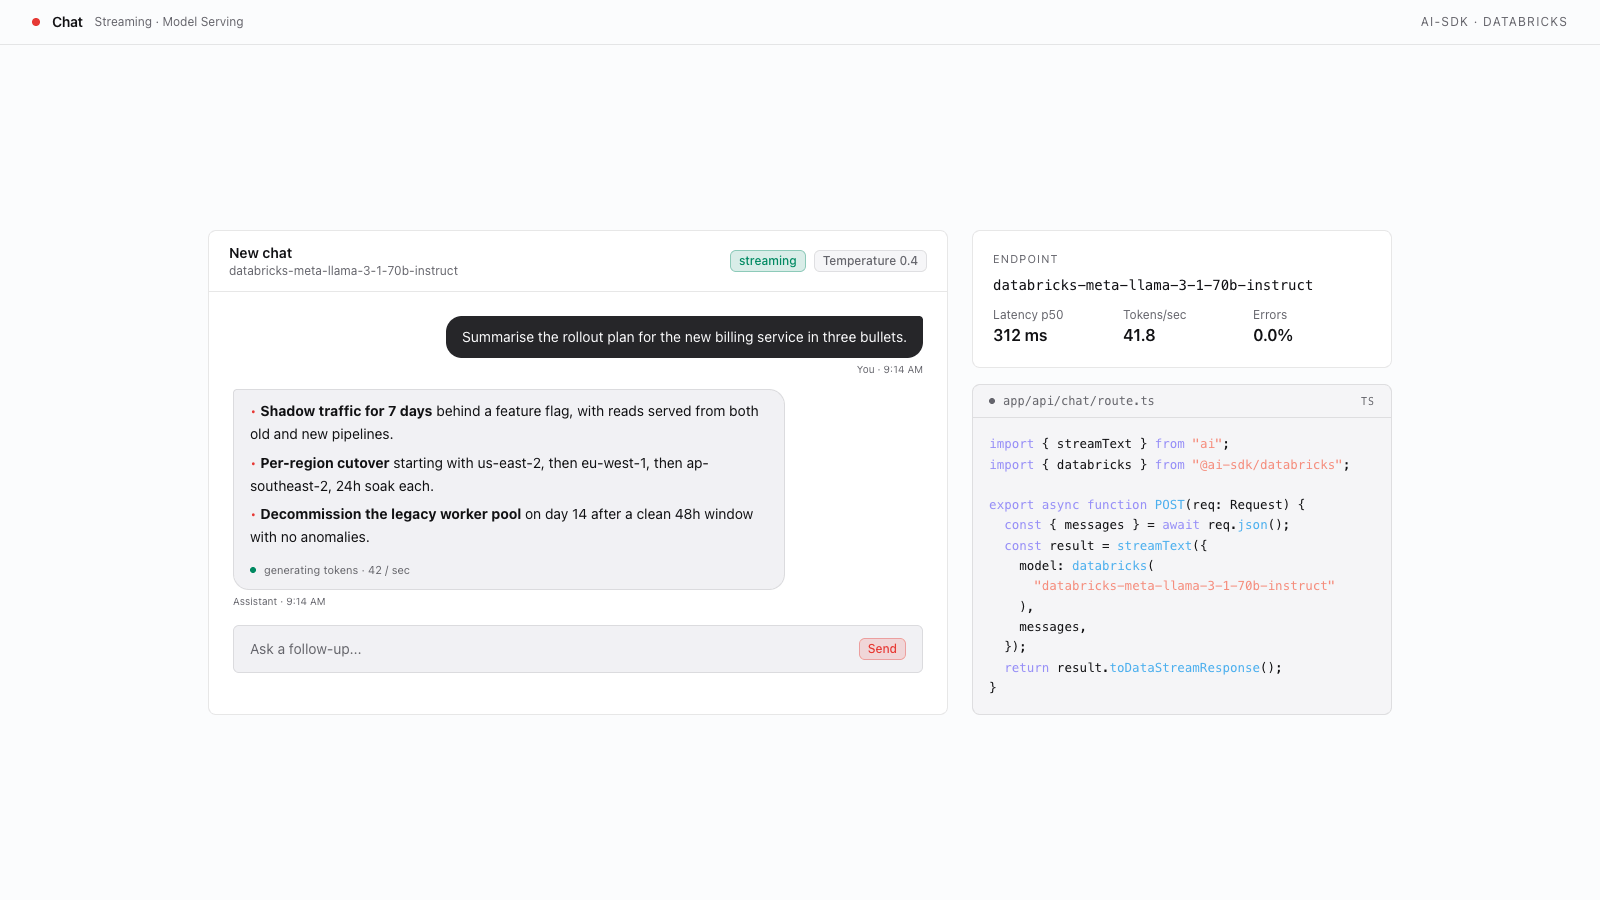
Chat IA en streaming avec Model Serving
Créez une expérience de chat IA en streaming à l’aide d’AI SDK et de points de terminaison Databricks Model Serving.
[MODÈLES]
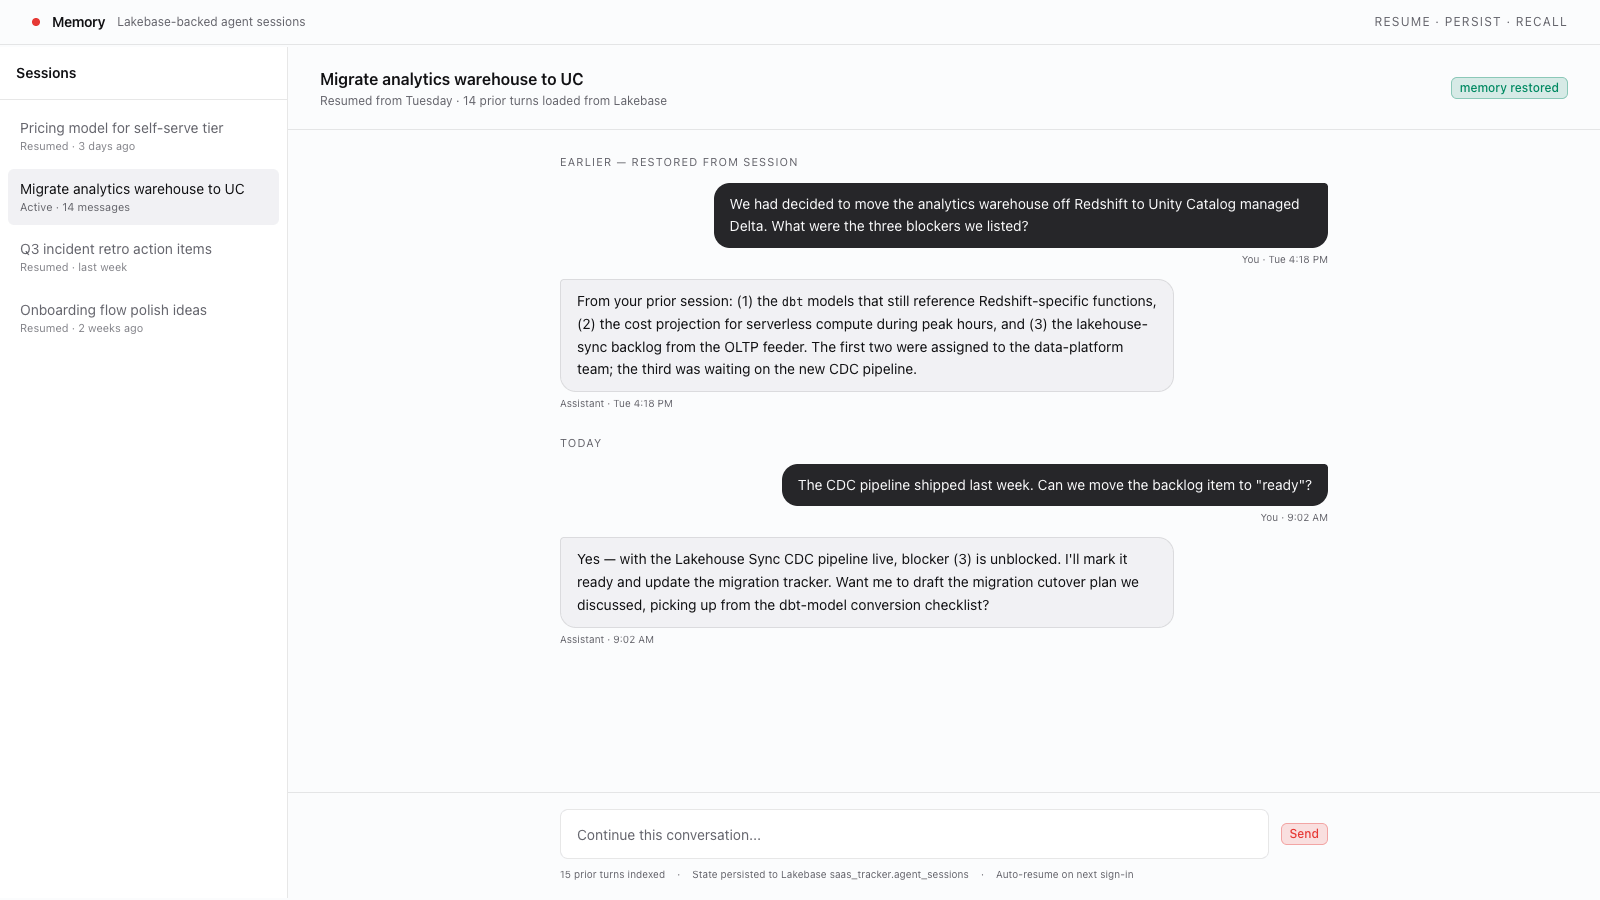
Mémoire d’agent Lakebase
Conservez les sessions et les messages de chat de votre agent IA dans Lakebase afin que les utilisateurs puissent reprendre leurs conversations et que votre agent puisse s’appuyer sur les échanges précédents entre les déploiements.