Lakebase pgvector
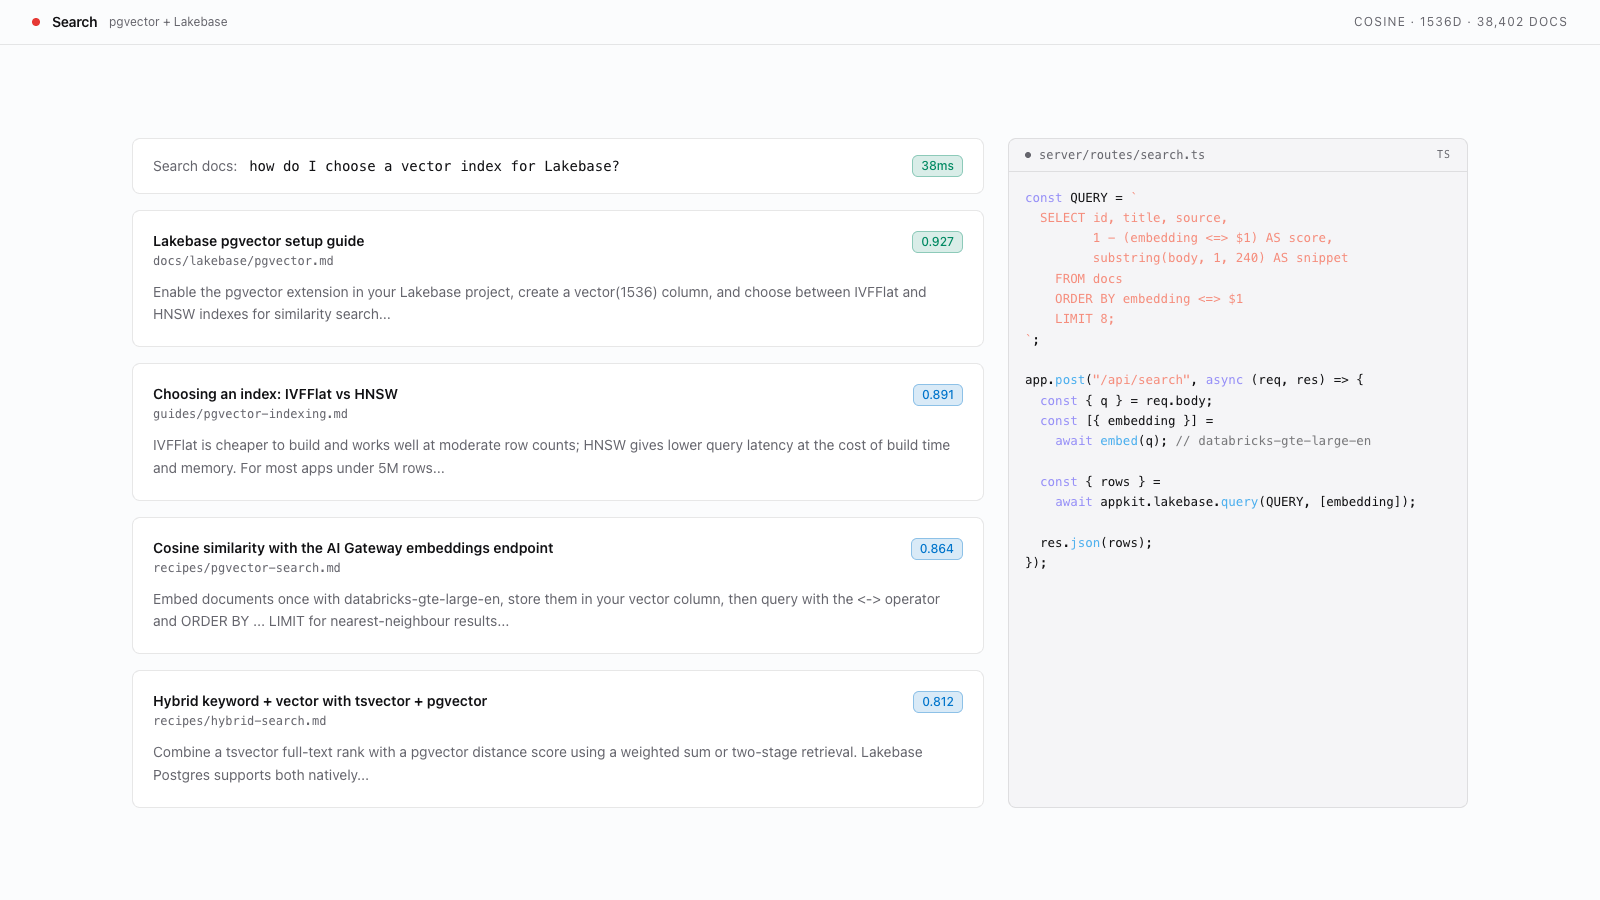
pgvector拡張機能を使用してLakebaseでベクトル類似性検索を有効にします。拡張機能の設定、ベクトルテーブル設計、挿入およびコサイン類似度検索ヘルパー、IVFFlat/HNSWインデックスのオプションを扱います。
AI で構築する
- 以下のプロンプトをコピーします
- Cursor、Claude Code、Codex、または任意のコーディングエージェントに貼り付けます
- エージェントが途中で質問しながら、希望どおりのものを構築します
テンプレートを初めて使う方へ:こちらで詳しく見る
完了すると、次のものが用意できます。
- Lakebase インスタンスで有効化された pgvector 拡張機能
- ディメンション数を設定可能なベクトル埋め込みテーブル
- ドキュメントの挿入と類似度検索を行うサーバーサイド関数
- 最近傍クエリを効率化する IVFFlat または HNSW インデックス
Prerequisites
開始する前に、次の Databricks ワークスペース機能が有効になっていることを確認してください。いずれかの確認に失敗した場合は、ワークスペース管理者に機能の有効化を依頼してください。
- Lakebase Postgres が利用可能であること。
databricks postgres list-projects --profile <PROFILE>を実行し、コマンドが成功することを確認します。not enabledエラーが返る場合、この ID では Lakebase を利用できません。 - プロビジョニング済みの Lakebase project があること。 まず Create a Lakebase Project テンプレートを完了してください。その primary endpoint に対して
vector拡張を有効化します。 - CLI で
databricks psqlが利用できること。databricks psql --helpを実行し、サブコマンドが存在することを確認します。存在しない場合は Databricks CLI をアップグレードしてください (Set Up Your Local Dev Environment を参照) 。