CDC履歴テーブルからのメダリオンアーキテクチャ
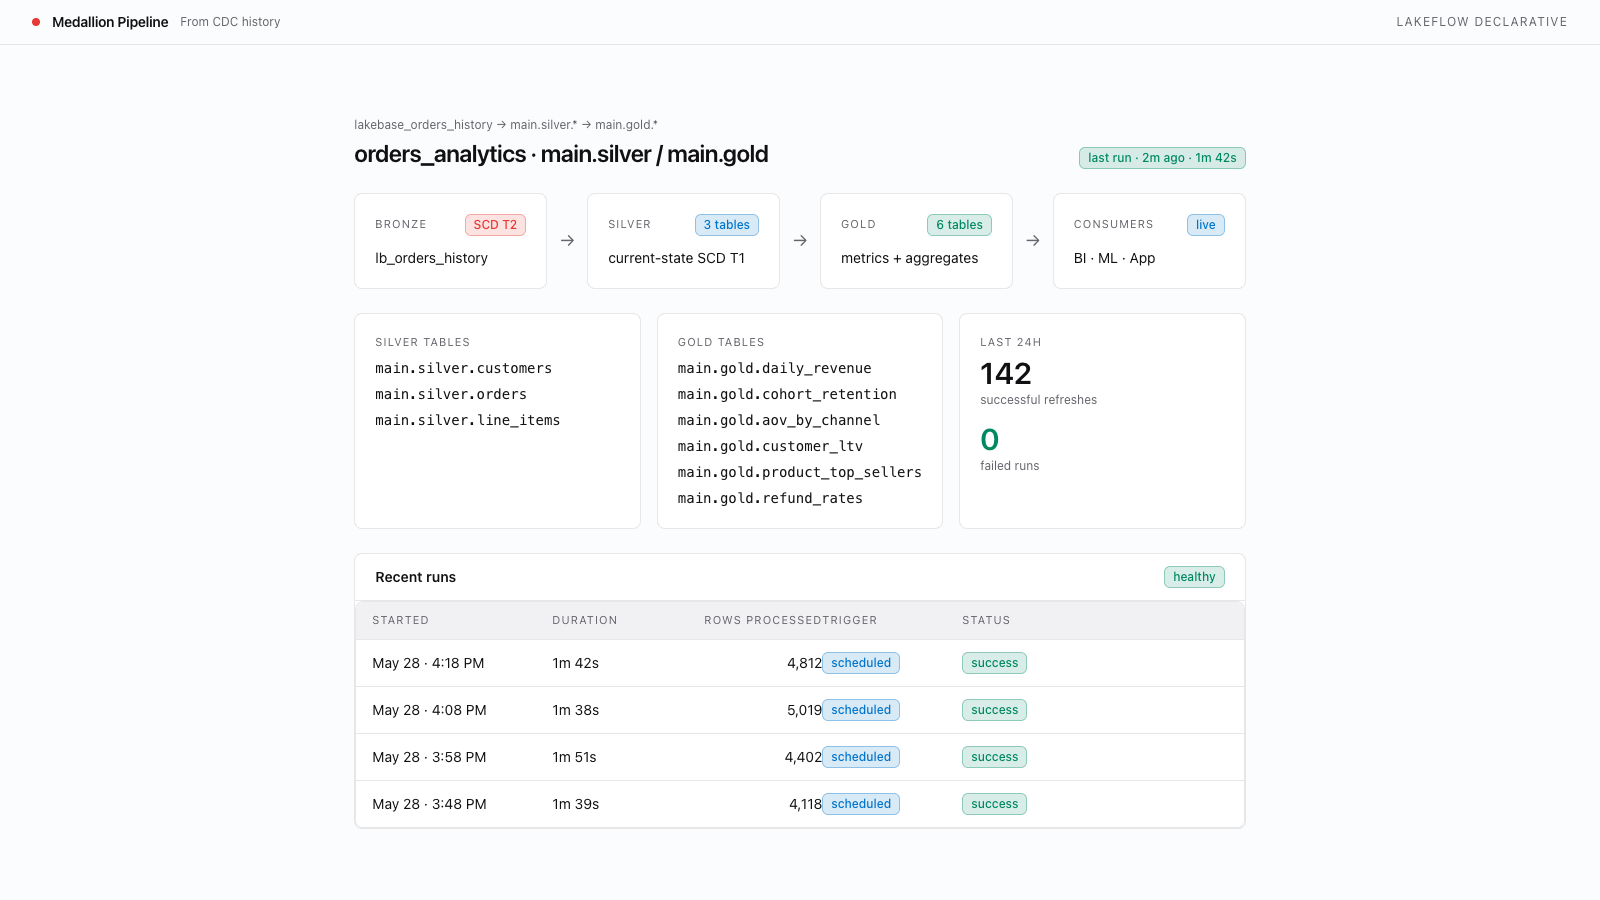
Lakeflow Spark Declarative Pipelinesを使用して、Lakebase Change Data Feed履歴テーブルを、シルバー(現在の状態)層とゴールド(集計)層を持つメダリオンアーキテクチャに変換します。
AI で構築する
- 以下のプロンプトをコピーします
- Cursor、Claude Code、Codex、または任意のコーディングエージェントに貼り付けます
- エージェントが途中で質問しながら、希望どおりのものを構築します
テンプレートを初めて使う方へ:こちらで詳しく見る
完了すると、次のものが得られます。
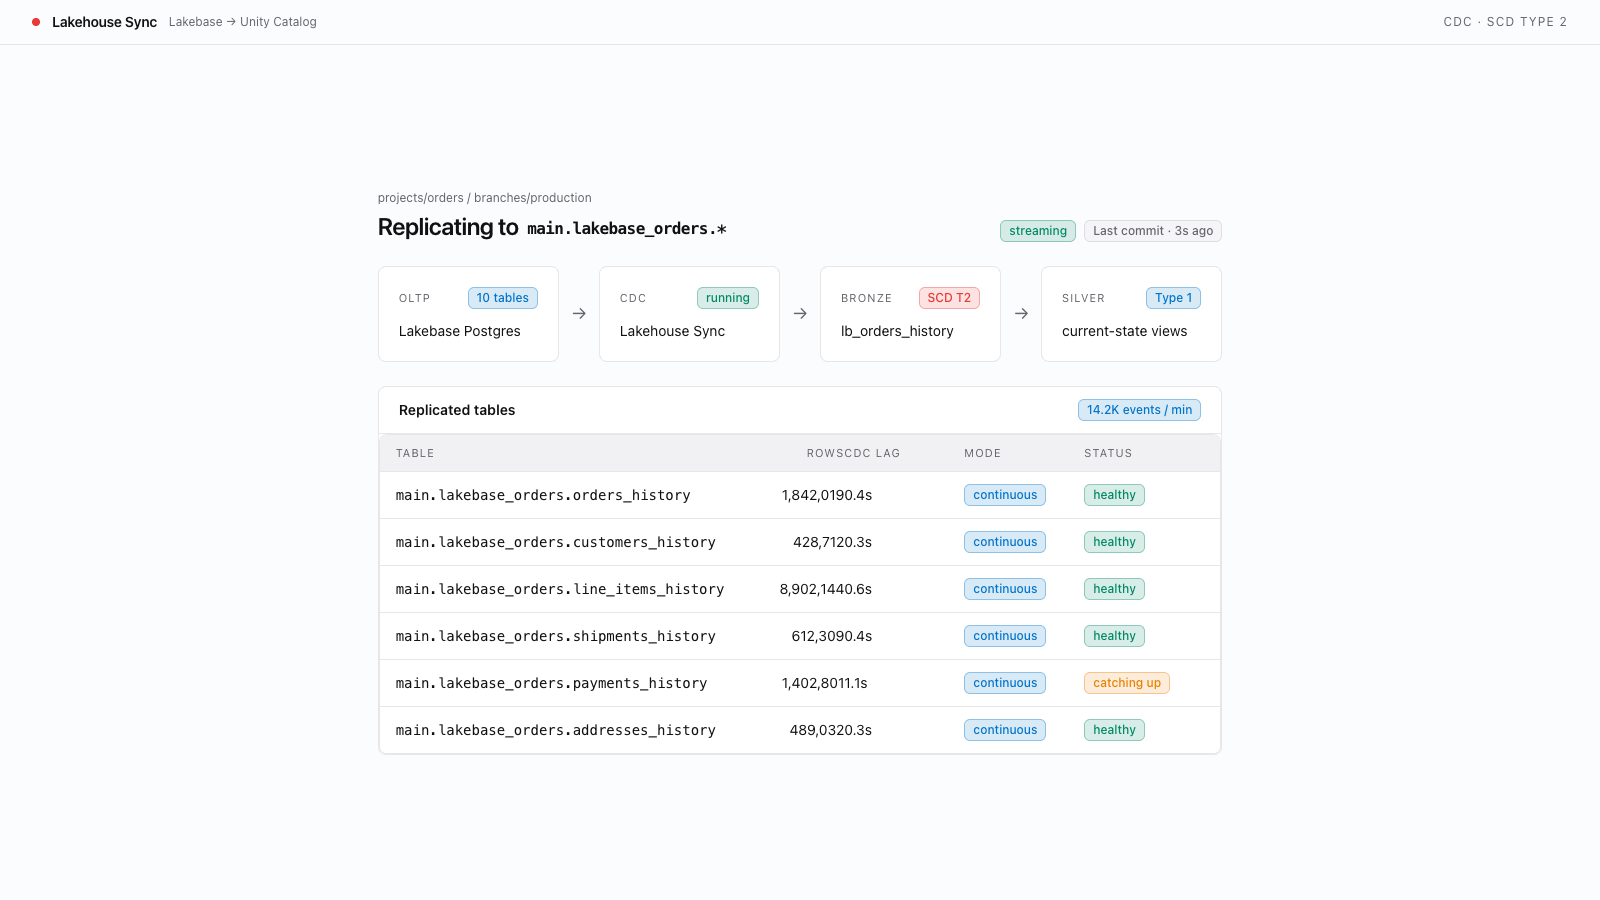
- 上流の Lakebase Change Data Feed 履歴テーブルが提供するブロンズレイヤー (このレシピの入力)
- エンティティごとに重複を排除し、現在の状態を表す materialized views を備えたシルバーレイヤー
- ビジネス集計とメトリクスを materialized views として提供するゴールドレイヤー
- シルバーレイヤーとゴールドレイヤーを増分的に refresh する、スケジュール実行の Lakeflow Spark 宣言型 pipeline
- SQL、Spark、BI ツール、Genie から Unity Catalog テーブルとしてクエリできるすべてのレイヤー
Prerequisites
このテンプレートは、既存の Lakebase Change Data Feed (CDF) 履歴テーブルの上に Lakeflow Spark Declarative Pipeline を構築します。開始する前に、以下の Databricks ワークスペース機能が有効になっていることを確認してください。
- Lakeflow Spark Declarative Pipelines (serverless) が利用可能であること。
databricks pipelines list-pipelines --profile <PROFILE>を実行し、コマンドが成功することを確認します (結果が空のリストでも問題ありません) 。permission エラーやnot enabledエラーが返る場合、この ID では Lakeflow Pipelines を利用できません。 - 書き込み可能な出力先 schema を持つ Unity Catalog へのアクセス権。
databricks catalogs list --profile <PROFILE>を実行し、出力先カタログが一覧に表示されることを確認します。silver および gold の materialized views を公開するには、カタログに対するUSE_CATALOG、出力先 schema に対するUSE_SCHEMAとCREATE_MATERIALIZED_VIEWが必要です (pipeline でストリーミングテーブルも作成する場合はCREATE_TABLEも必要) 。 - ブロンズ CDC 履歴テーブルが Unity Catalog にすでに存在すること。 先に Lakebase Change Data Feed (Autoscaling) テンプレートを完了し、ブロンズ schema に
lb_<entity>_historyテーブルがある状態にしてください。このテンプレートはそれらのテーブルを読み取るだけで、テーブルの作成は行いません。