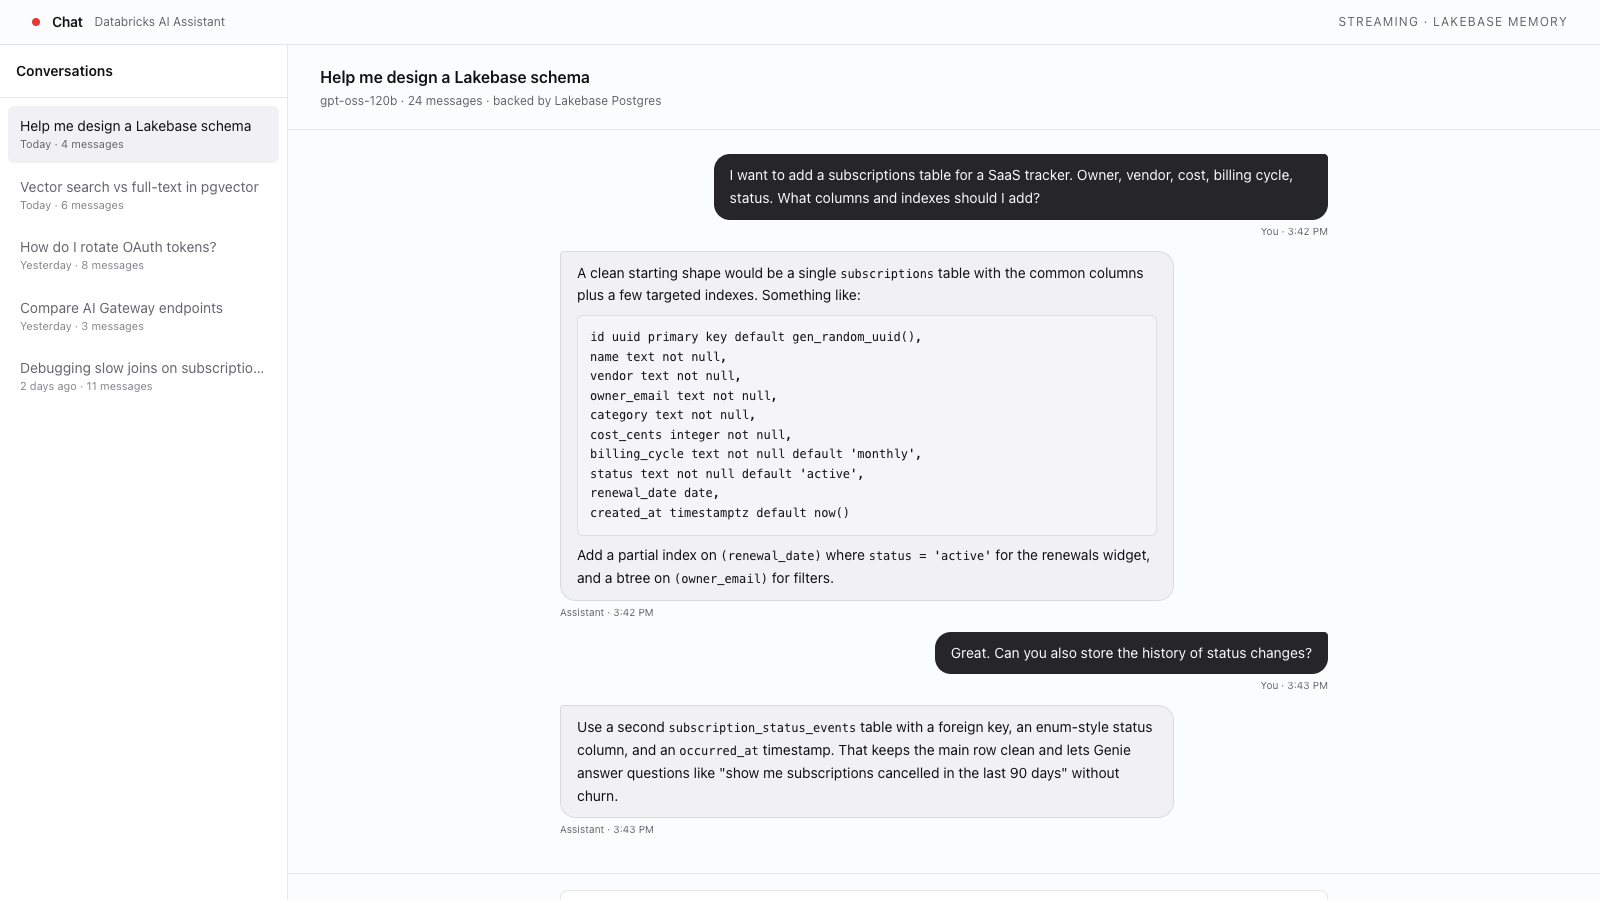
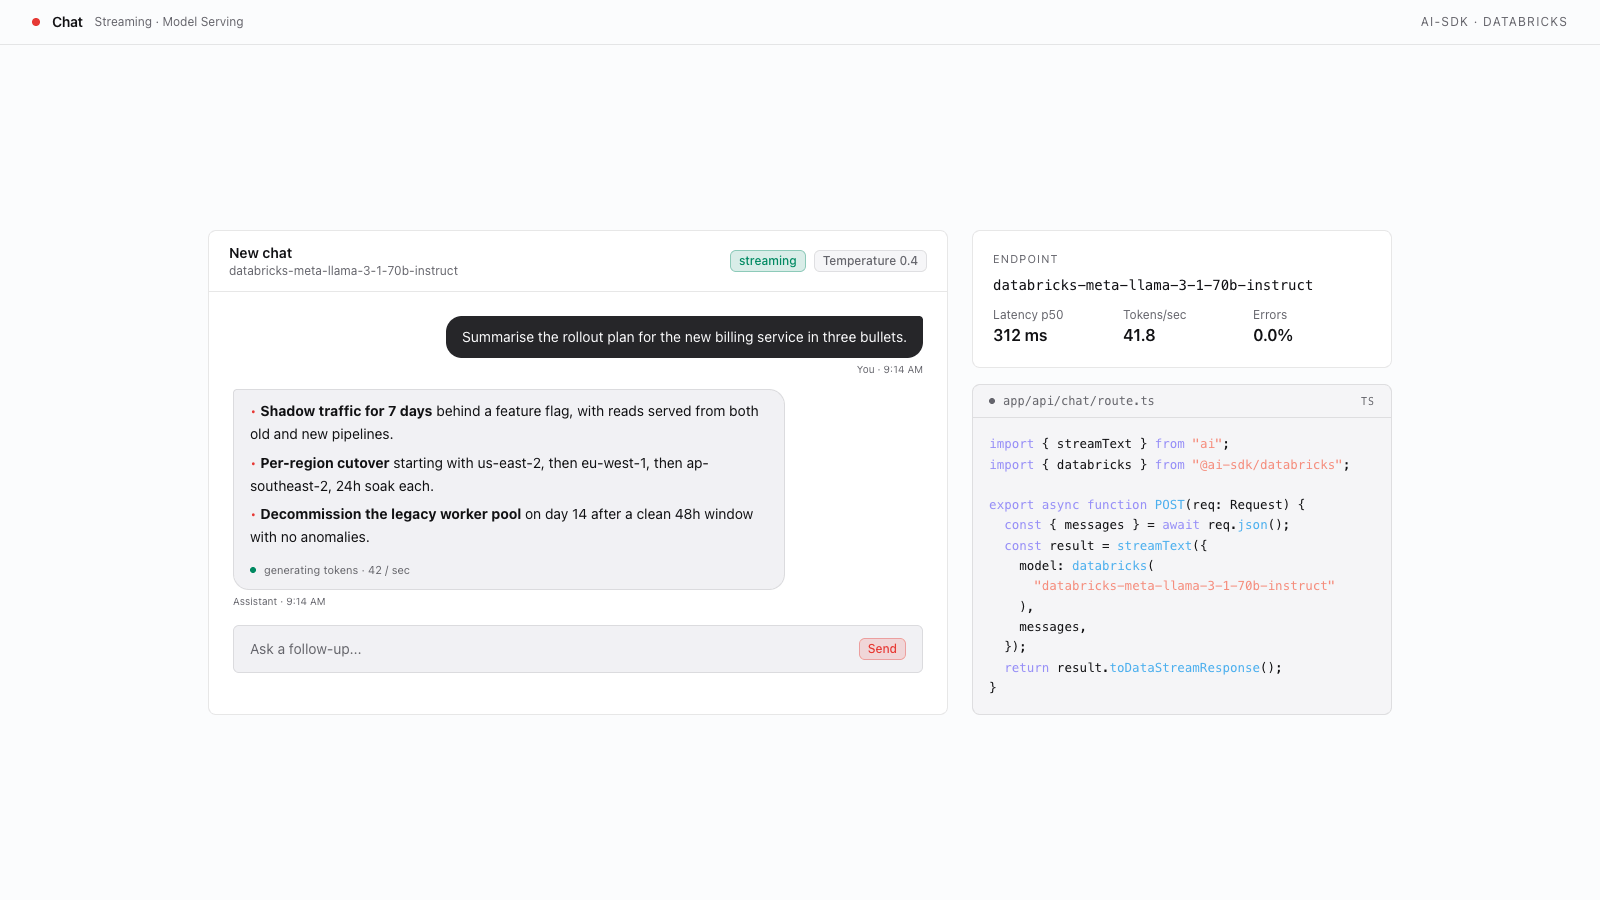
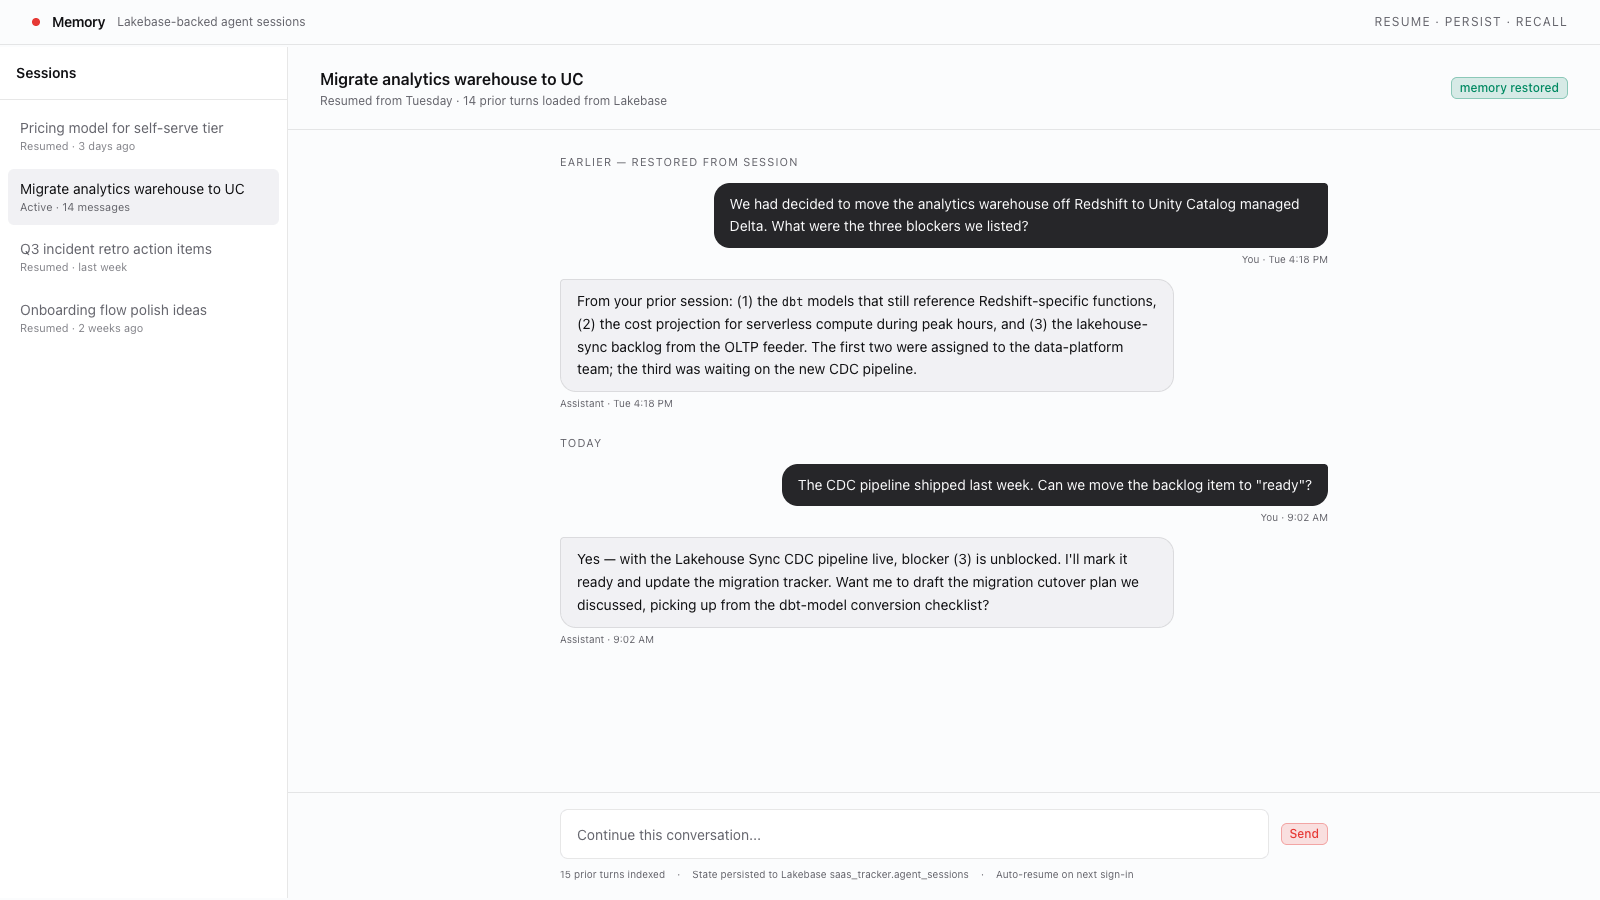
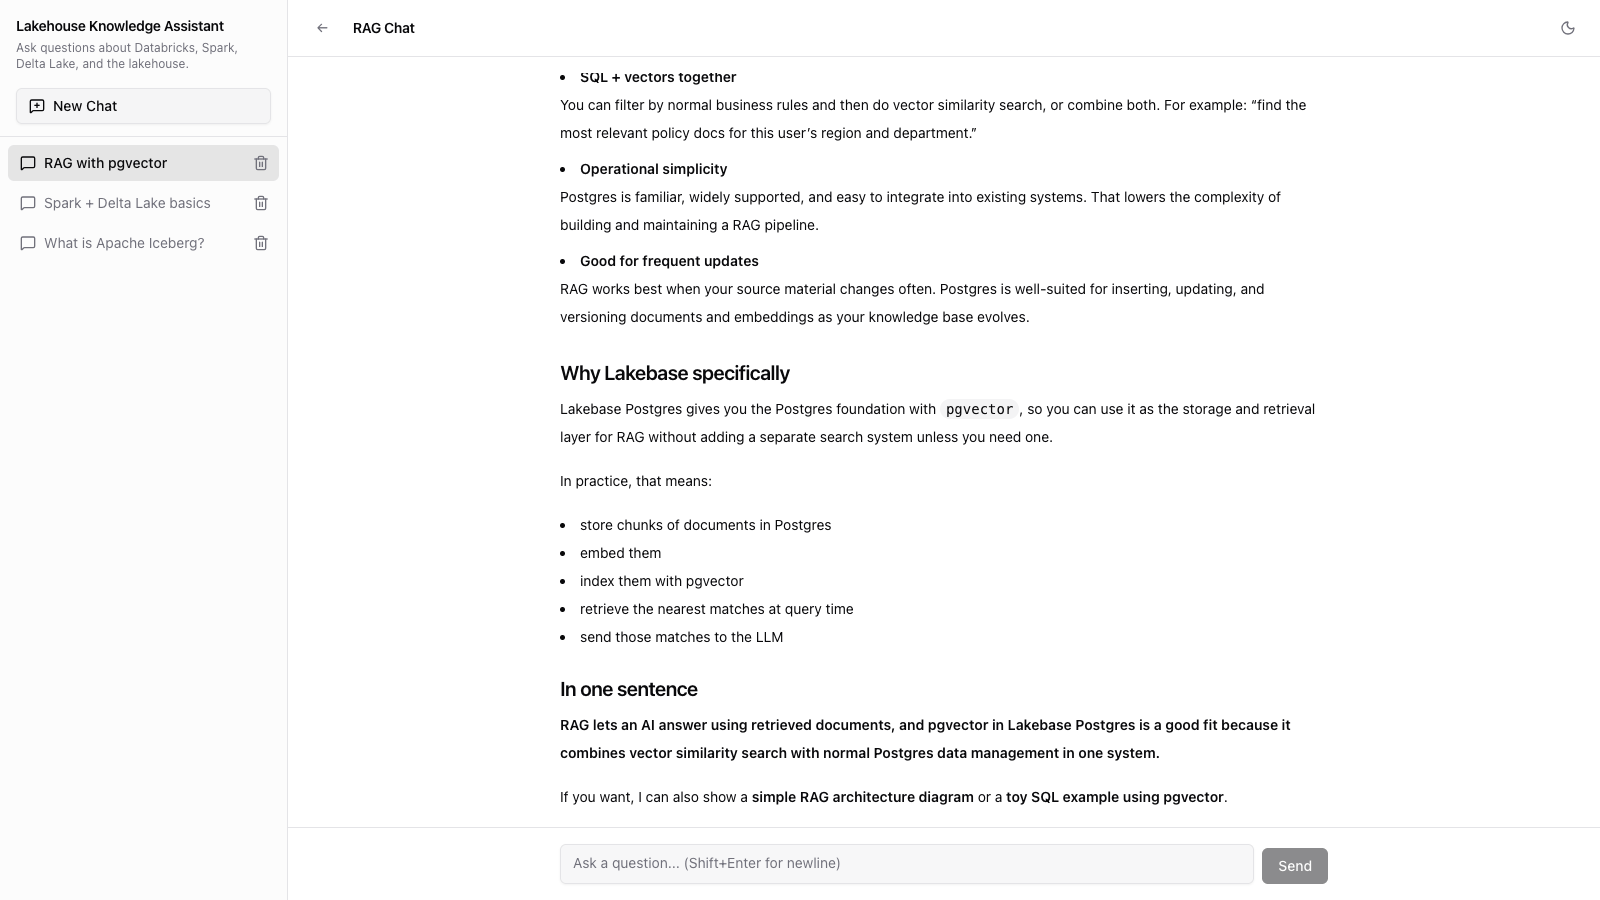
RAG チャットアプリ
Lakebase の pgvector 検索、Wikipedia のシードコーパス、Model Serving による生成、Lakebase に保存されるチャット履歴を備えたストリーミング Retrieval-Augmented Generation チャットアプリ。`databricks apps init` で利用できます。
AI で構築する
- 以下のプロンプトをコピーします
- Cursor、Claude Code、Codex、または任意のコーディングエージェントに貼り付けます
- エージェントが途中で質問しながら、希望どおりのものを構築します
テンプレートを初めて使う方へ:こちらで詳しく見る
動作するスターターアプリが含まれています
実行可能な実際のコードは GitHub にあります。上記のプロンプトをコピーすると、コーディングエージェントが開始点としてリポジトリをクローンし、データやユースケースに合わせて調整します。
このテンプレートは、Databricks 上に構築した検索拡張生成 (RAG) チャットアプリの例です。ユーザーの質問を埋め込みベクトルに変換し、Lakebase Postgres の pgvector ストアから類似ドキュメントを取得したうえで、そのコンテキストを Model Serving の呼び出しに組み込み、回答をストリーミングで返します。会話と参照元はチャットごとに Lakebase に永続化されます。
データフロー
検索とチャットの状態はすべて Lakebase Postgres に保持され、生成には Model Serving を使用します。
- シーディング: 起動時に少数の Wikipedia 記事を取得し、段落単位でチャンクに分割したうえで、各チャンクを foundation-model の埋め込み endpoint (既定では
databricks-gte-large-en) でベクトル化し、vector(1024)カラムを持つrag.documentsに行として書き込みます。 - ユーザーのターン: 同じ endpoint でベクトル化されます。サーバーは pgvector によるコサイン類似度検索を実行し、上位 k 件の一致するチャンクを取得します。
- コンテキストの注入: 取得したチャンクはシステムメッセージとして先頭に付加され、ユーザーの会話履歴とともに Model Serving 経由でチャット補完 endpoint (既定では
databricks-gpt-5-4-mini) へ送信されます。 - ストリーミング:
streamTextが token をクライアントへストリーミングし、その間にonFinishコールバックがアシスタントのターンを Lakebase に追記します。 - chat history: ユーザーとアシスタントのすべてのターンが
chat_idをキーとしてchat.messagesに永続化されるため、会話を再開できます。
テンプレートのアプローチ
他の templates とは異なり、このテンプレートは git clone ではなく databricks apps init 経由で利用することを前提に設計されています。init フローの動作は次のとおりです。
- Lakebase Postgres の branch 名とデータベースリソース名の入力を求めます。
- Lakebase API を呼び出して
PGHOST、PGDATABASE、LAKEBASE_ENDPOINTを自動解決し、ローカルの.envに書き込みます。 - Databricks CLI の設定に基づいて
DATABRICKS_CONFIG_PROFILEまたはDATABRICKS_HOSTを書き込みます。 --nameで指定した名前で、すぐに実行できる状態のプロジェクトディレクトリを用意します。
これは、AppKit templates システム が DevHub テンプレートをリリースする手段として使えることを実証するものです。仕組みの詳細は、テンプレート内の appkit.plugins.json と .env.tmpl を参照してください。
適応すべき箇所
setup とプロビジョニングについてはリポジトリの README.md に記載されています。
このテンプレートを自分の用途に合わせるには、次の点を変更します。
- Lakebase: バンドルが参照する Lakebase の project、branch、データベースを自分のものに変更します (init 時に入力を求められます) 。
- Model Serving endpoint: 別のチャットモデル (例:
databricks-claude-sonnet-4-6) を使う場合はDATABRICKS_ENDPOINTを上書きします。 - 埋め込み endpoint: 別の埋め込みモデルを使いたい場合は
DATABRICKS_EMBEDDING_ENDPOINTを上書きします。その際、server/lib/rag-store.tsのvector(N)の次元数が一致しているか確認してください。 - シードデータ:
server/lib/seed-data.tsの Wikipedia 記事リストを独自のコーパスに置き換えます。チャンク分割関数は段落境界で分割するため、ソースの構造が異なる場合は適宜調整してください。 - 検索: 既定の top-k は 5、類似度指標はコサインです。
retrieveSimilar()で調整できます。
これらのテンプレートを基に構築
この例のコードベースと上記のエージェントプロンプトは、いずれも以下のテンプレートを基に構築されています。テンプレートを開いて特定の手法を詳しく確認したり、別のプロジェクトに適用したりできます。
[テンプレート]
AIチャットアプリ
Model Serving統合、AI SDKストリーミングチャット、Lakebaseに永続化されたチャット履歴。

[テンプレート]
Model ServingによるストリーミングAIチャット
AI SDKとDatabricks Model Servingエンドポイントを使用して、ストリーミングAIチャット体験を構築します。
[テンプレート]
Lakebaseエージェントメモリ
AIエージェントのチャットセッションとメッセージをLakebaseに永続化し、ユーザーが会話を再開できるようにするとともに、エージェントがデプロイをまたいで過去のターンを参照して推論できるようにします。