Console de suporte baseado em agentes
Console de suporte completo com IA que combina Lakebase, Change Data Feed, um pipeline medalhão, um job de agente LLM, sincronização reversa e um Databricks App com análises do Genie.
Crie com IA
- Copie o prompt abaixo
- Cole-o no Cursor, Claude Code, Codex ou em qualquer agente de programação
- Seu agente cria o app, fazendo perguntas ao longo do processo para que o resultado seja exatamente como você deseja
Não conhece os modelos? Saiba mais aqui
Inclui um app inicial funcional
O código funcional e executável está no GitHub. Ao copiar o prompt acima, seu agente de programação o clona como ponto de partida e o adapta aos seus dados e caso de uso.
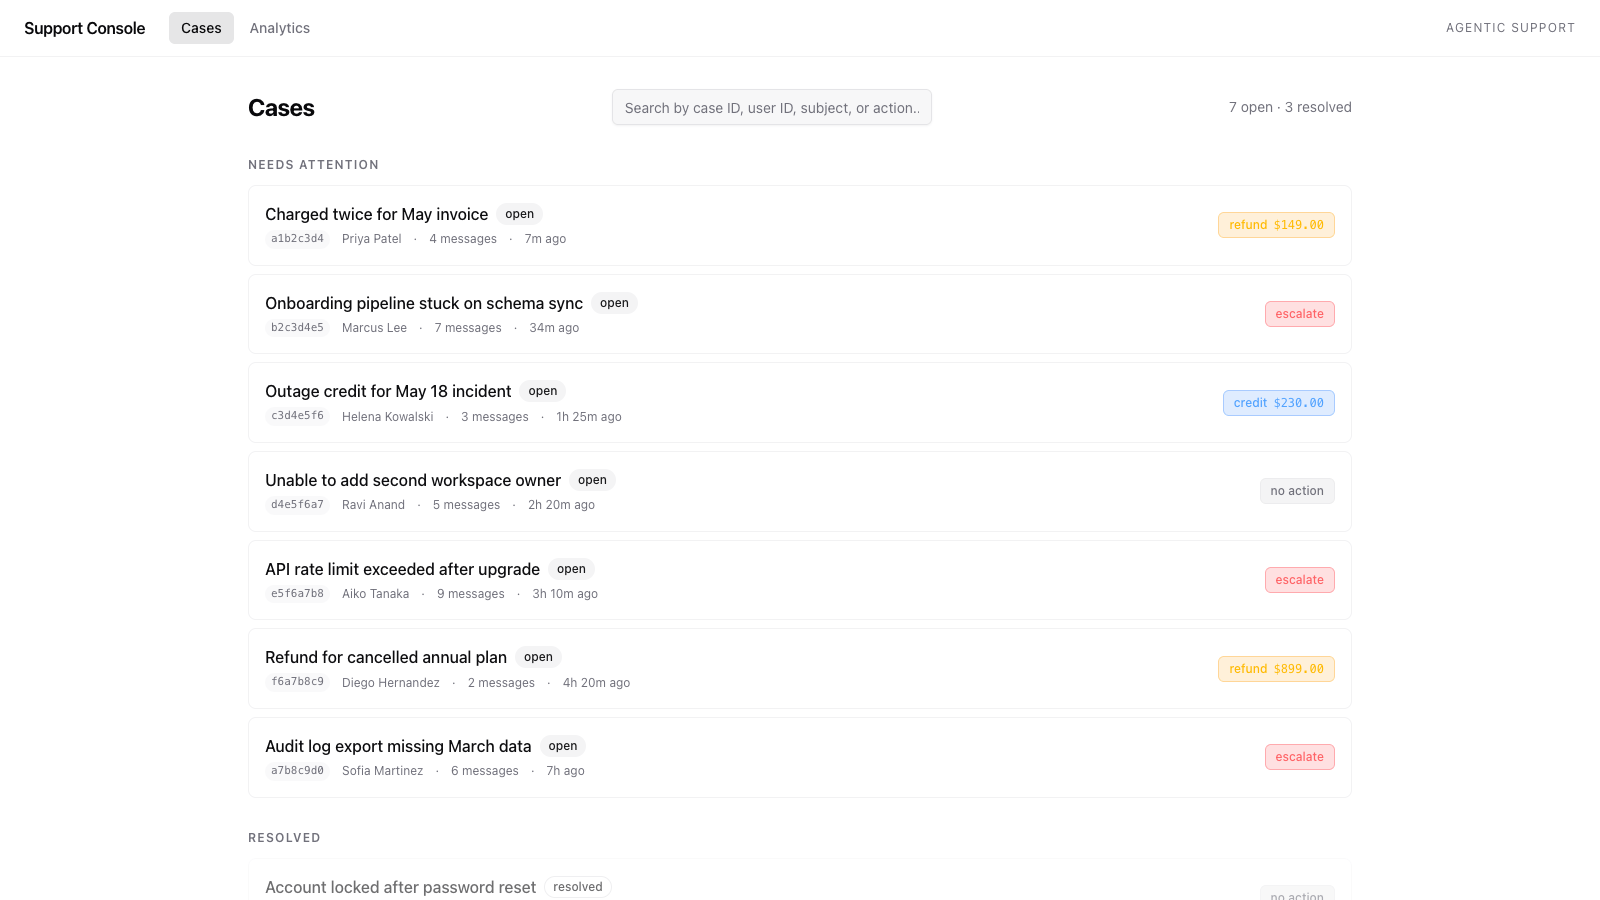
Este modelo reúne toda a pilha de desenvolvimento da Databricks em um único aplicativo de dados operacional: um console de suporte com IA em que cada mensagem de cliente é triada automaticamente por um LLM, e os atendentes de suporte revisam, aprovam ou substituem a sugestão a partir de uma ferramenta interna criada sob medida.
Fluxo de Dados
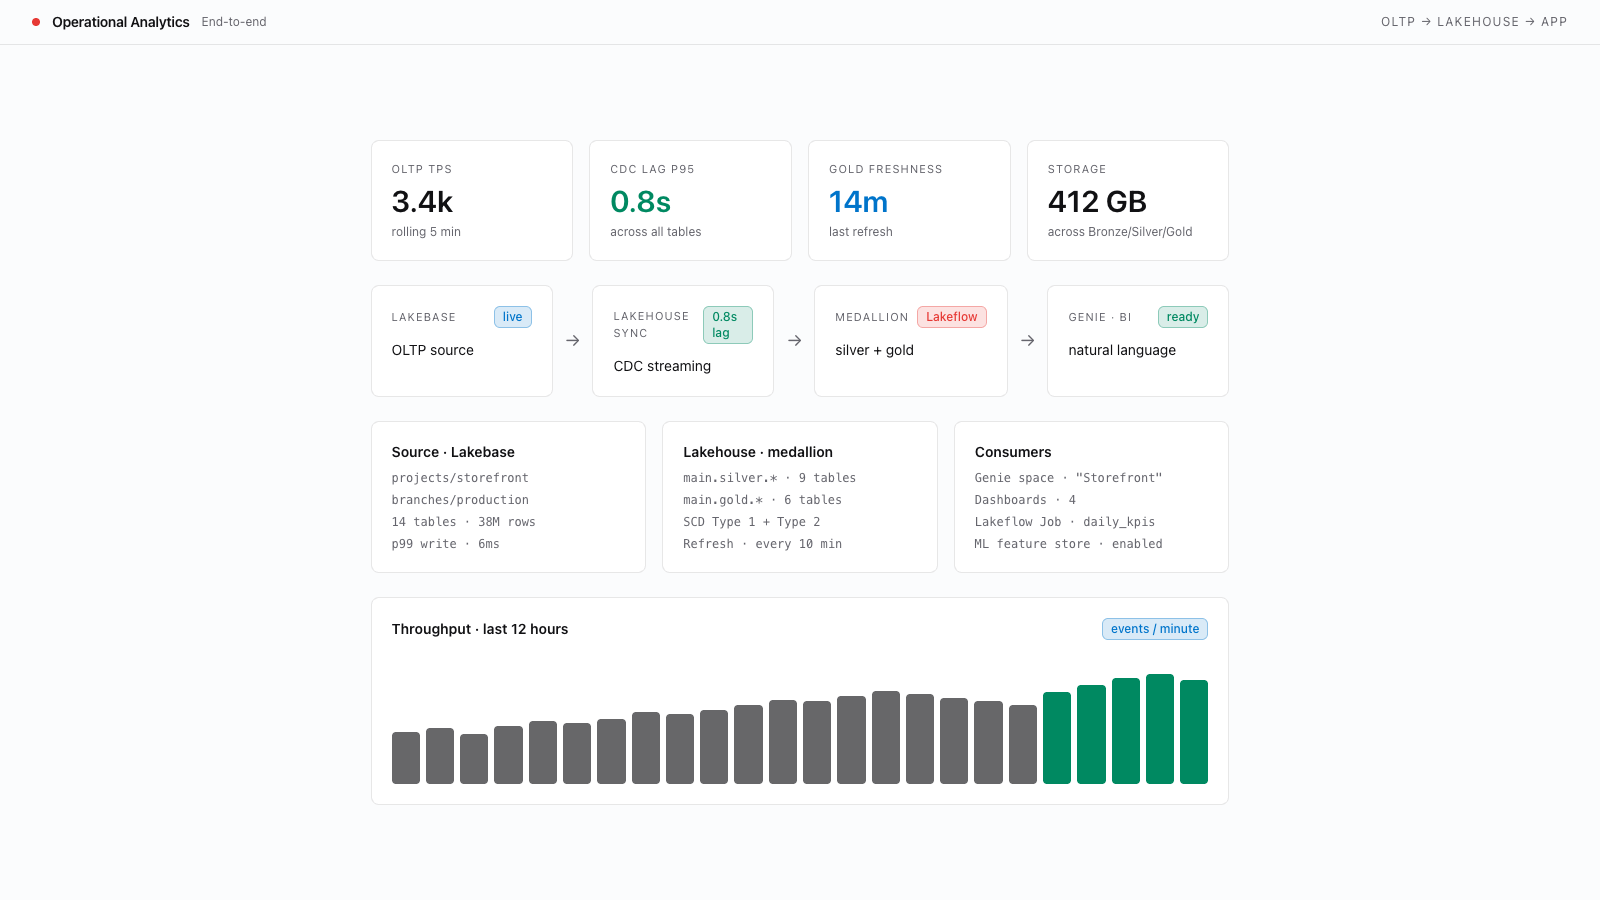
As interações dos clientes fluem do banco de dados OLTP da sua aplicação (Lakebase Postgres) para o lakehouse via CDC, são enriquecidas por um agente de IA e voltam ao console de suporte por meio de sincronização reversa:
- As gravações OLTP chegam ao Lakebase Postgres (usuários, pedidos, casos de suporte, mensagens).
- O Lakebase Change Data Feed (CDF) replica cada alteração para o Unity Catalog como tabelas de histórico CDC (camada bronze).
- Um Lakeflow Spark Declarative Pipeline transforma o histórico CDC em tabelas silver de estado atual e em visualizações materializadas gold analíticas (receita diária, visão geral do suporte, perfis de usuários, contexto dos casos).
- Um Lakeflow Job é executado a cada minuto, localiza mensagens sem resposta, monta um contexto rico a partir das tabelas gold, chama um LLM por meio de um Model Serving endpoint e mescla as respostas sugeridas em uma tabela Delta.
- As synced tables (sincronização reversa) replicam as tabelas gold de volta para o Lakebase, permitindo leituras de baixa latência.
- O Support Console (Databricks App) lê tanto do OLTP quanto das tabelas gold sincronizadas para apresentar casos, sugestões de IA e análises.
O que adaptar
O provisionamento (etapas manuais e SQL), o seeding, os deploys das pipelines, a sincronização reversa e o deploy do app estão documentados no README.md do repositório, junto ao código.
Para adaptar este modelo às suas necessidades:
- Catálogo: defina a variável
catalognodatabricks.ymlde cada pipeline com o nome do seu catálogo no Unity Catalog. - Lakebase: aponte o
databricks.ymldo app para o seu próprio projeto, branch e banco de dados do Lakebase. - Tabelas: o script de seed cria o schema OLTP. Depois do seeding, configure o Change Data Feed para replicar as tabelas do seu schema
public. - Sync Tables: crie manualmente as quatro configurações de sincronização reversa (consulte o README para ver os mapeamentos exatos das tabelas).
- Serving Endpoint: defina a variável
endpointcom o serving endpoint de modelo de sua preferência. - Genie Agent: crie um Genie Agent sobre suas tabelas gold e defina o
genie_space_idno bundle do app.
Baseado nestes modelos
O código deste exemplo e o prompt do agente acima são baseados nos modelos abaixo. Abra um deles para explorar uma técnica específica isoladamente ou aplicá-la a outro projeto.
[MODELOS]
Análise de dados operacionais
Configuração completa para analisar dados de bancos de dados operacionais no Lakehouse: Unity Catalog com armazenamento externo, provisionamento do Lakebase, replicação com o Lakebase Change Data Feed (CDF) e um pipeline de arquitetura medalhão com camadas silver e gold.

[MODELOS]
Aplicação com Lakebase
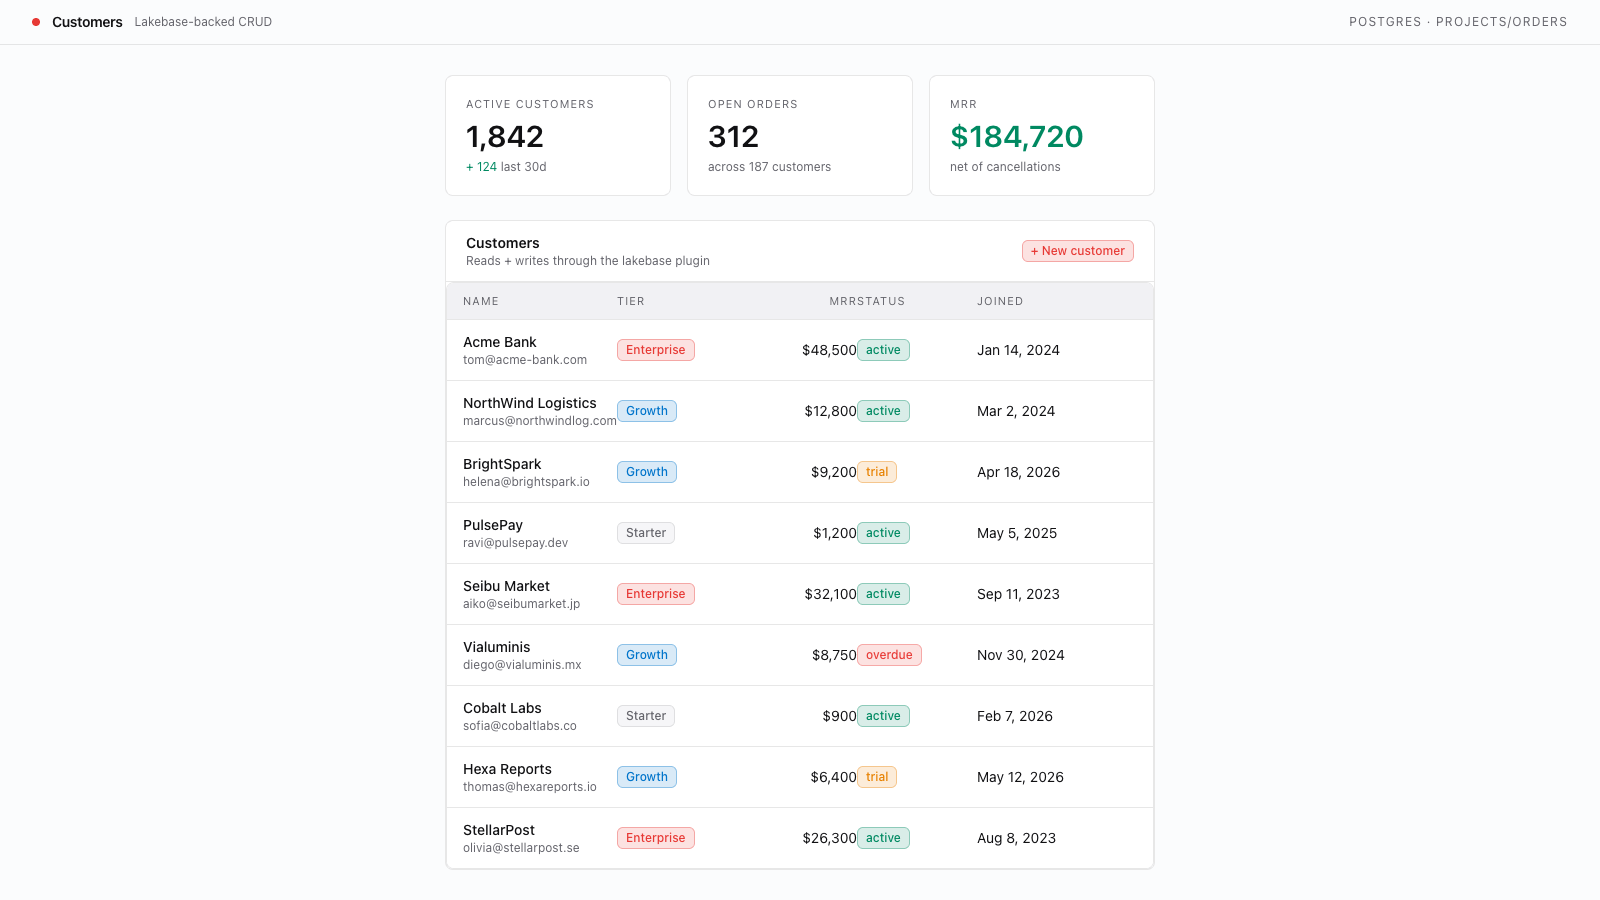
Configure um Databricks App com o Lakebase para armazenamento persistente de dados. Inclui configuração de esquema e rotas completas de API para CRUD.
[MODELOS]
Análise Conversacional do Genie
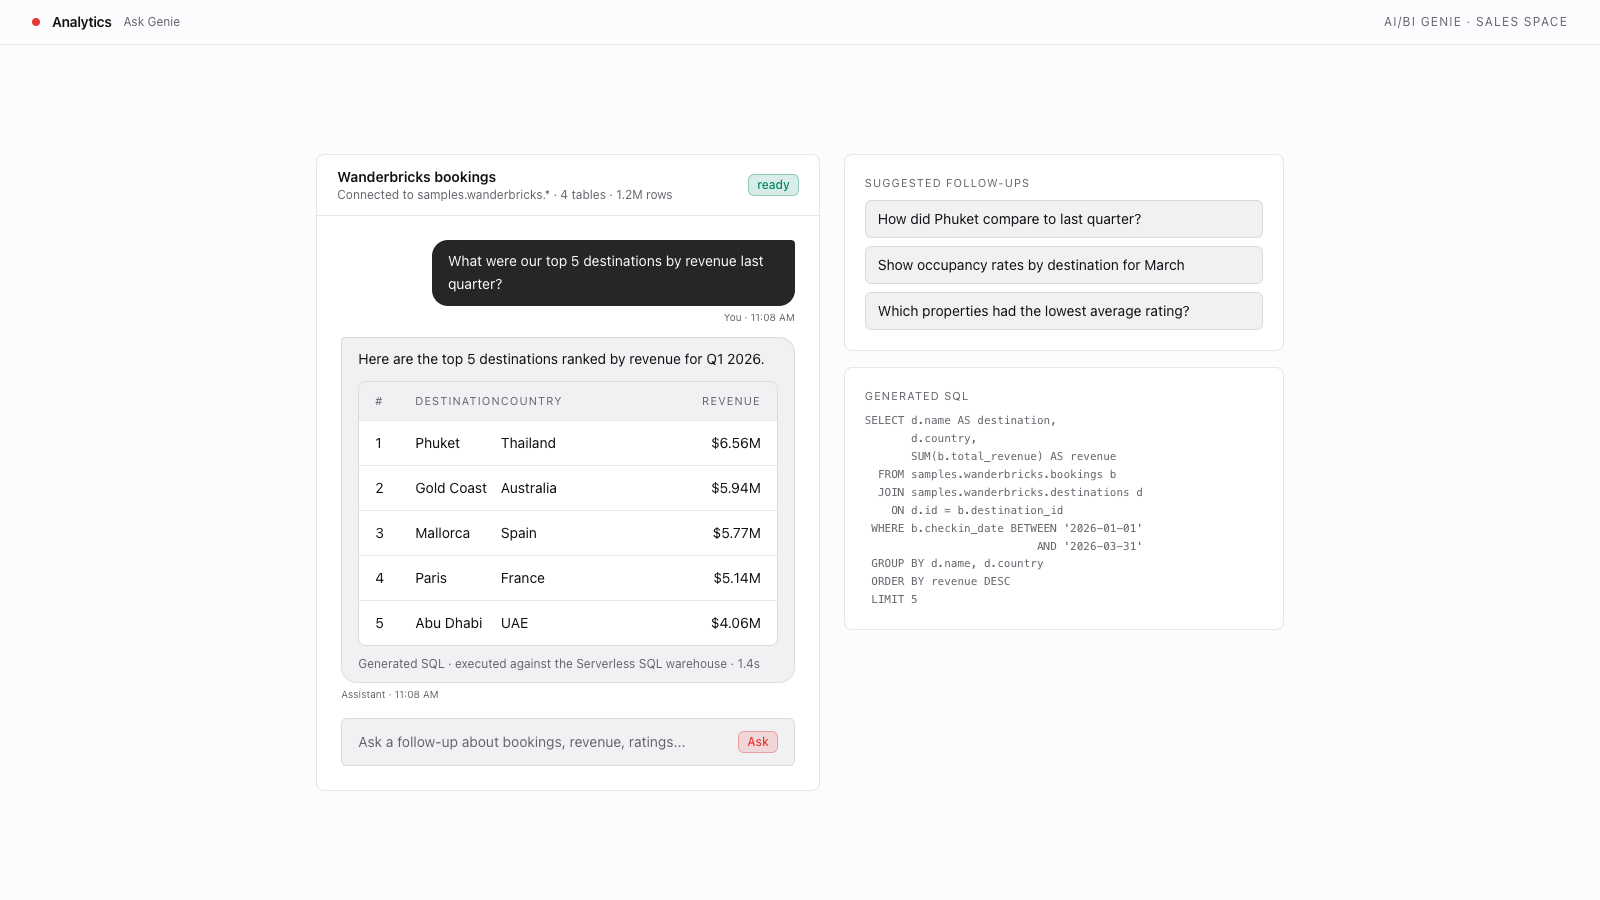
Incorpore uma interface de chat do Databricks AI/BI Genie para que os usuários possam explorar dados em linguagem natural. Configure um Genie Agent, conecte plugins de servidor e cliente, declare recursos da aplicação e implante.
[MODELOS]
Consulte Endpoints de Modelos Fundamentais
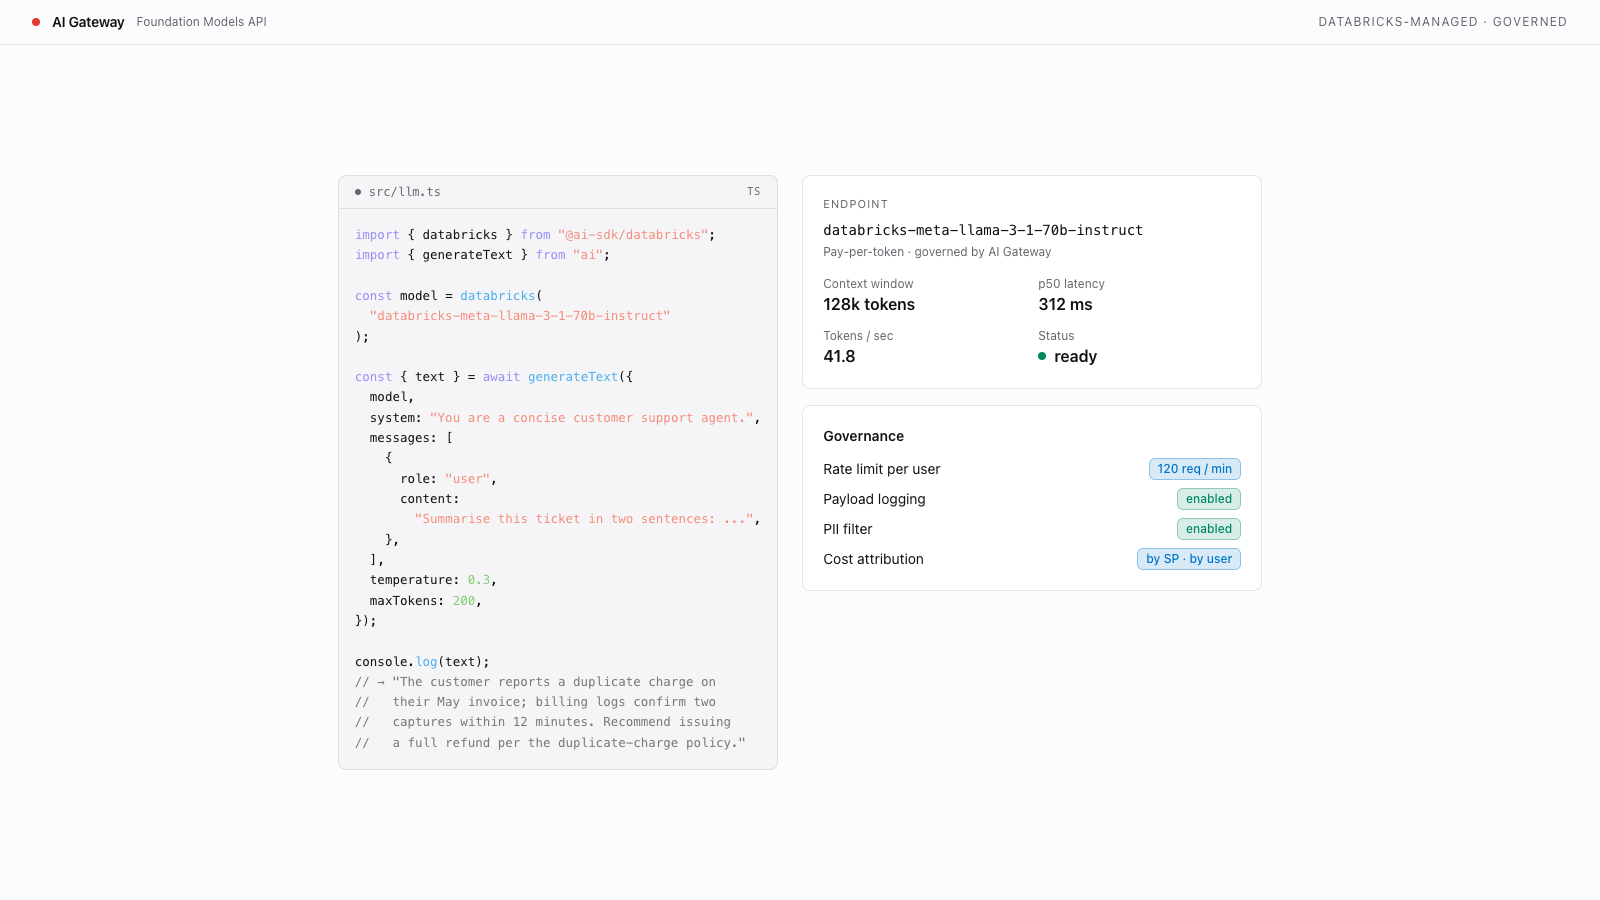
Consulte endpoints de modelos fundamentais do Databricks para acessar modelos hospedados e prontos para produção, com governança integrada do AI Gateway.