Arquitetura de Medalhão a partir de Tabelas de Histórico de CDC
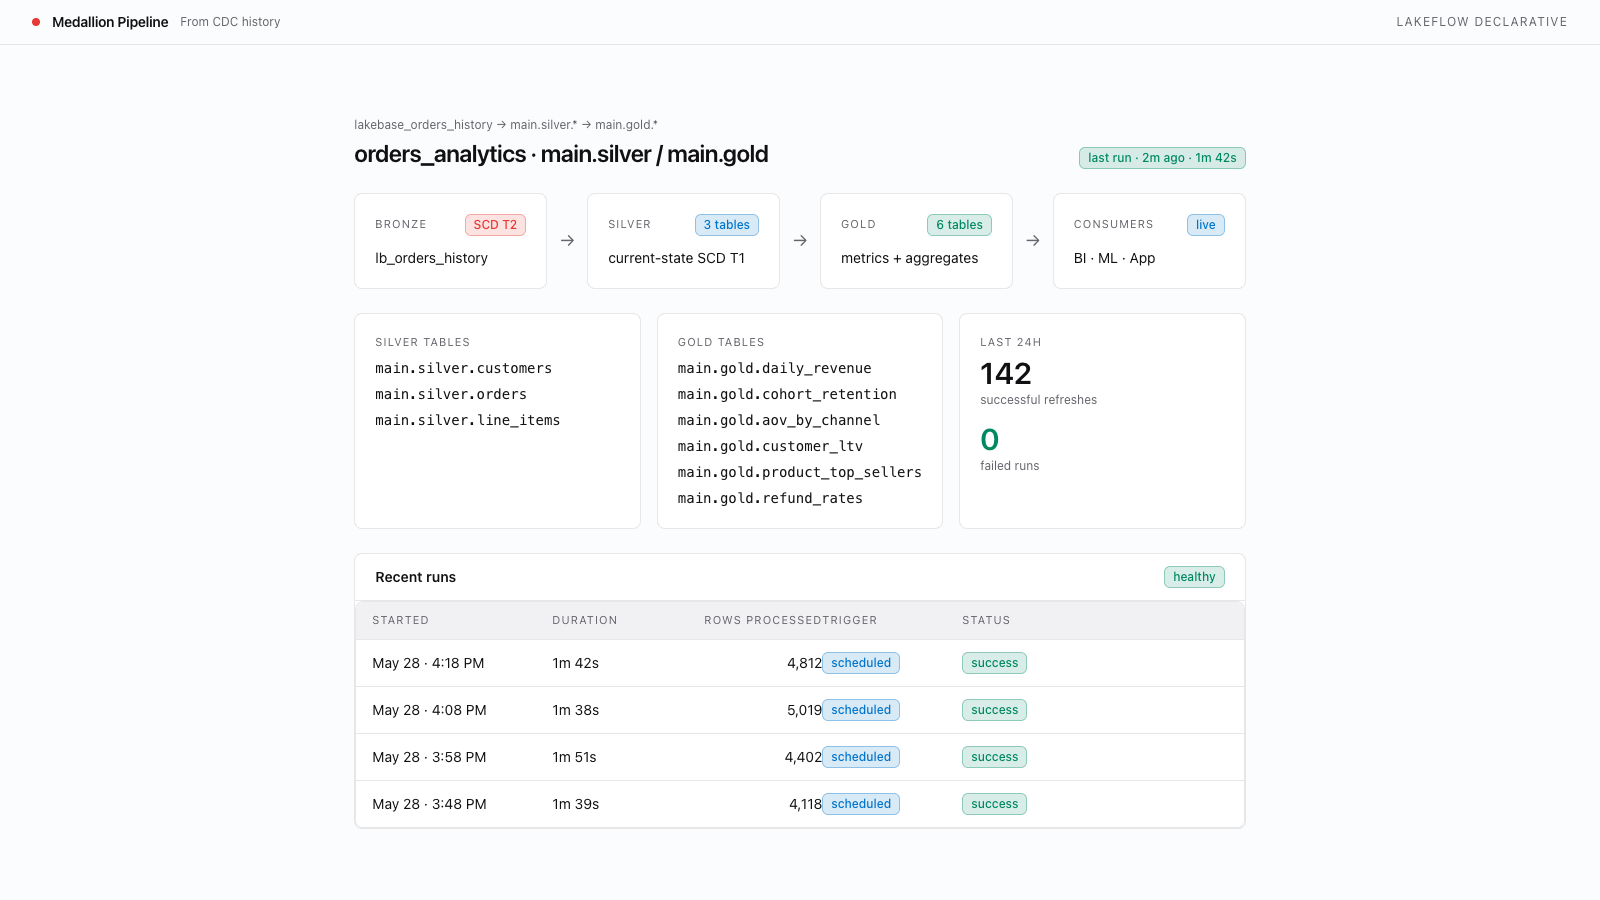
Transforme tabelas de histórico do Lakebase Change Data Feed em uma arquitetura de medalhão com camadas silver (estado atual) e gold (agregações) usando Lakeflow Spark Declarative Pipelines.
Crie com IA
- Copie o prompt abaixo
- Cole-o no Cursor, Claude Code, Codex ou em qualquer agente de programação
- Seu agente cria o app, fazendo perguntas ao longo do processo para que o resultado seja exatamente como você deseja
Não conhece os modelos? Saiba mais aqui
Ao final, você terá:
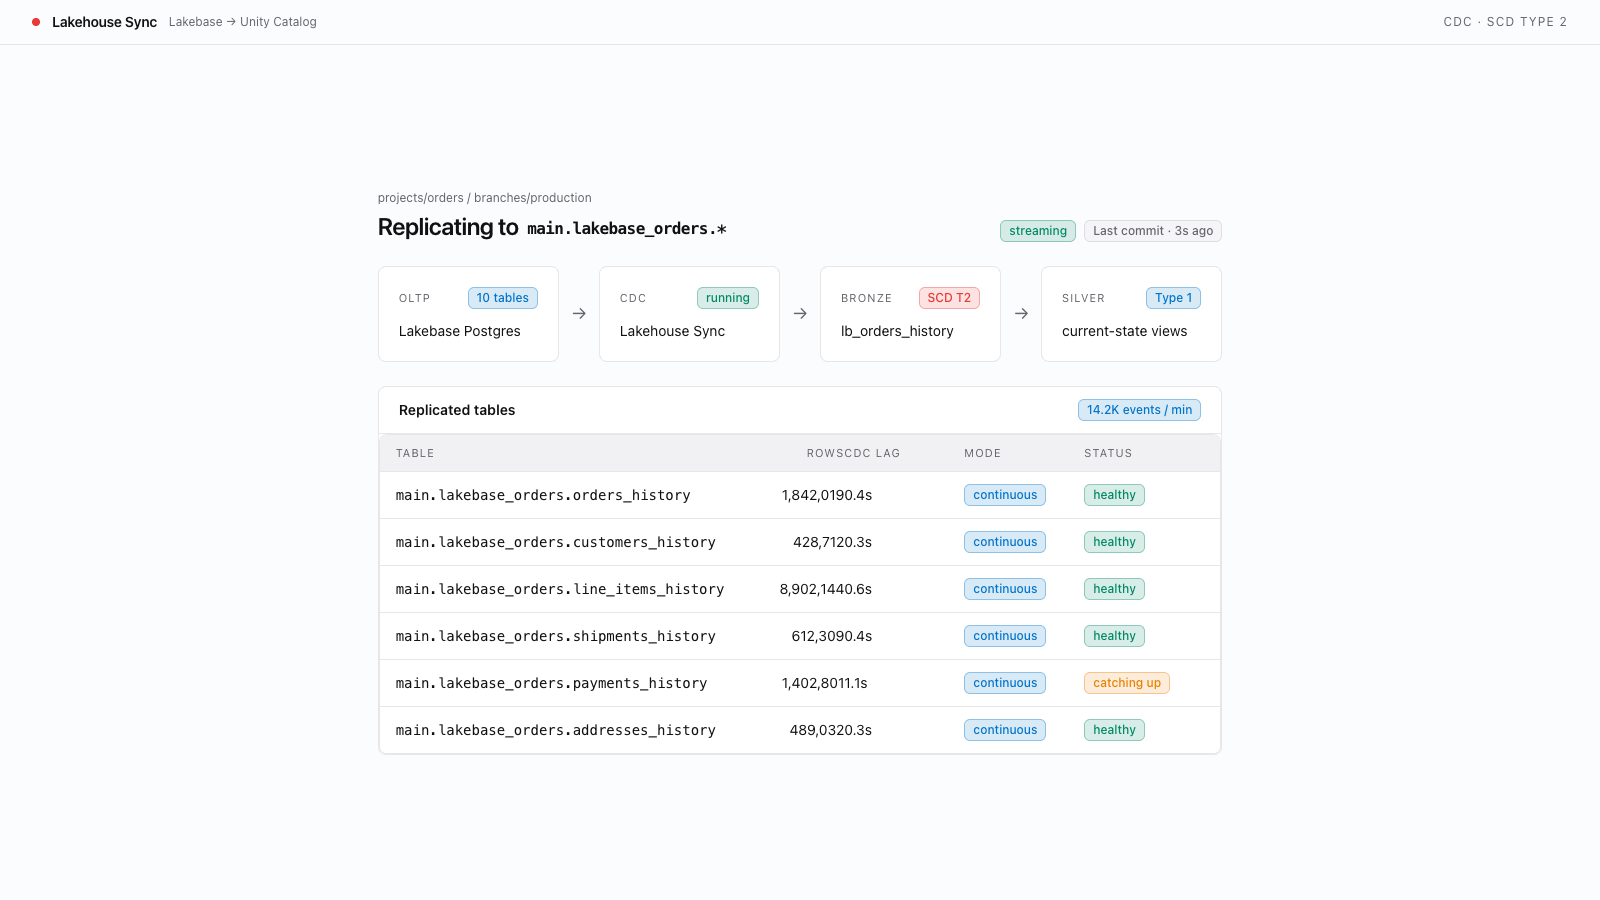
- Uma camada bronze fornecida pelas tabelas de histórico do Change Data Feed do Lakebase upstream (entrada desta receita)
- Uma camada silver com visualizações materializadas de estado atual e sem duplicatas para cada entidade
- Uma camada gold com agregações e métricas de negócio como visualizações materializadas
- Um Lakeflow Spark Declarative Pipeline agendado, atualizando as camadas silver e gold de forma incremental
- Todas as camadas disponíveis para consulta como tabelas do Unity Catalog via SQL, Spark, ferramentas de BI e Genie
Prerequisites
Este modelo cria um Lakeflow Spark Declarative Pipeline sobre tabelas de histórico de Change Data Feed (CDF) já existentes no Lakebase. Verifique se estes recursos do workspace Databricks estão habilitados antes de começar.
- Lakeflow Spark Declarative Pipelines (serverless) disponível. Execute
databricks pipelines list-pipelines --profile <PROFILE>e confirme que o comando é bem-sucedido (uma lista vazia não é problema). Um erro de permissão ounot enabledindica que o Lakeflow Pipelines não está disponível para essa identidade. - Acesso ao Unity Catalog com um schema de destino gravável. Execute
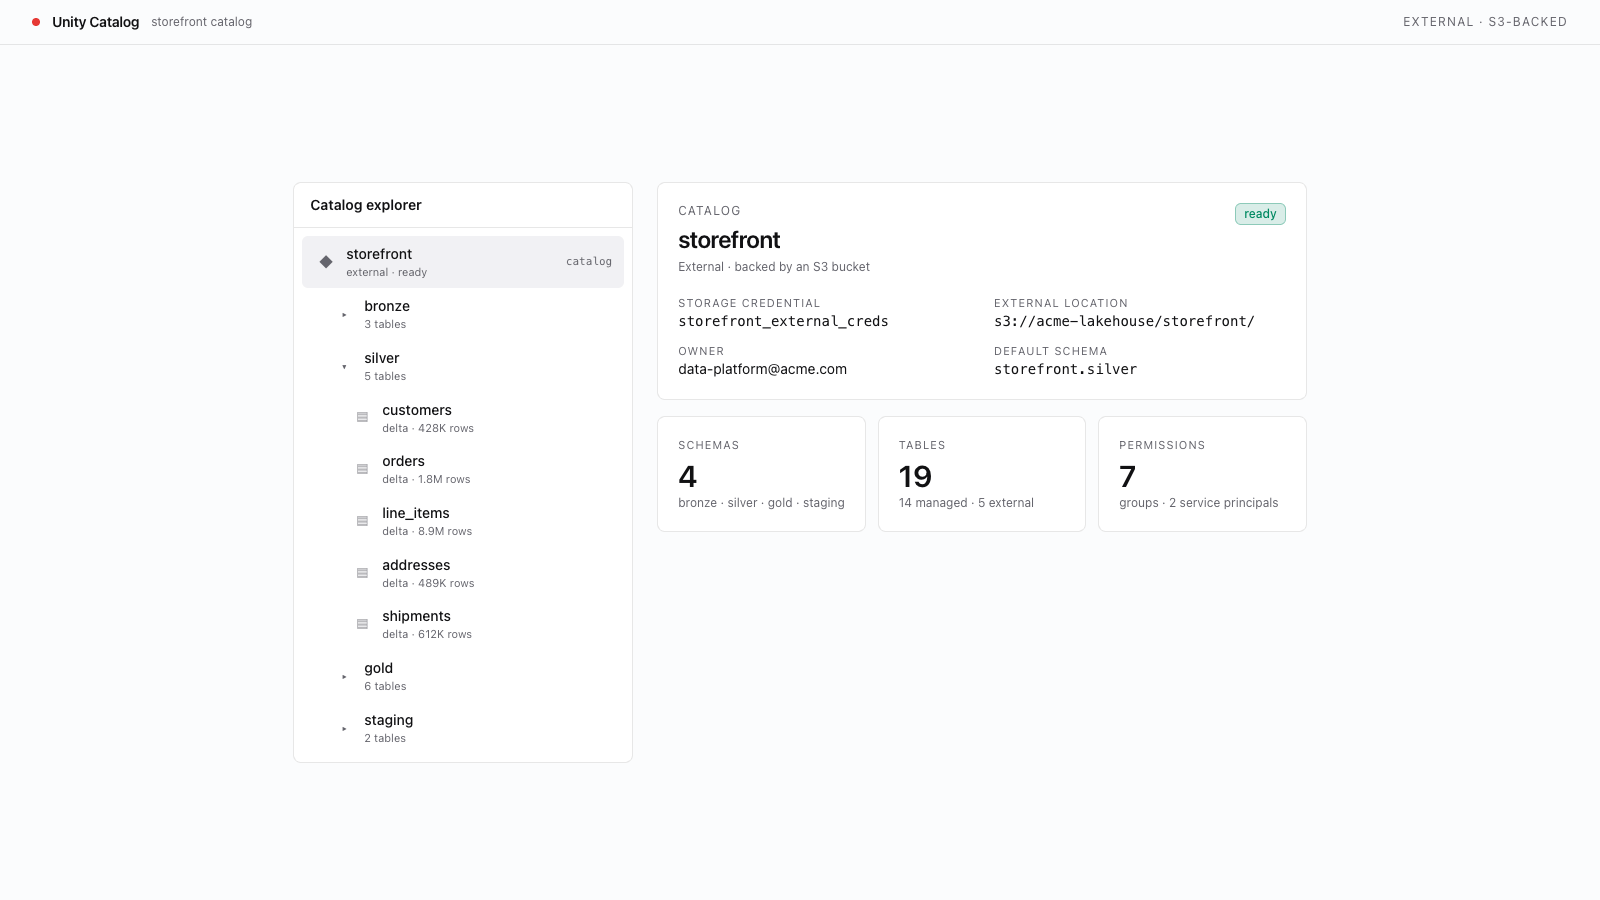
databricks catalogs list --profile <PROFILE>e confirme que seu catálogo de destino aparece na lista. Você precisará deUSE_CATALOGno catálogo e deUSE_SCHEMA+CREATE_MATERIALIZED_VIEWno schema de destino para publicar as visualizações materializadas silver e gold (além deCREATE_TABLE, caso o pipeline também crie tabelas de streaming). - Tabelas de histórico CDC bronze já presentes no Unity Catalog. Conclua primeiro o modelo Lakebase Change Data Feed (Autoscaling) para que as tabelas
lb_<entity>_historyexistam no schema bronze. Este modelo apenas lê essas tabelas; ele não as cria.