App de chat RAG
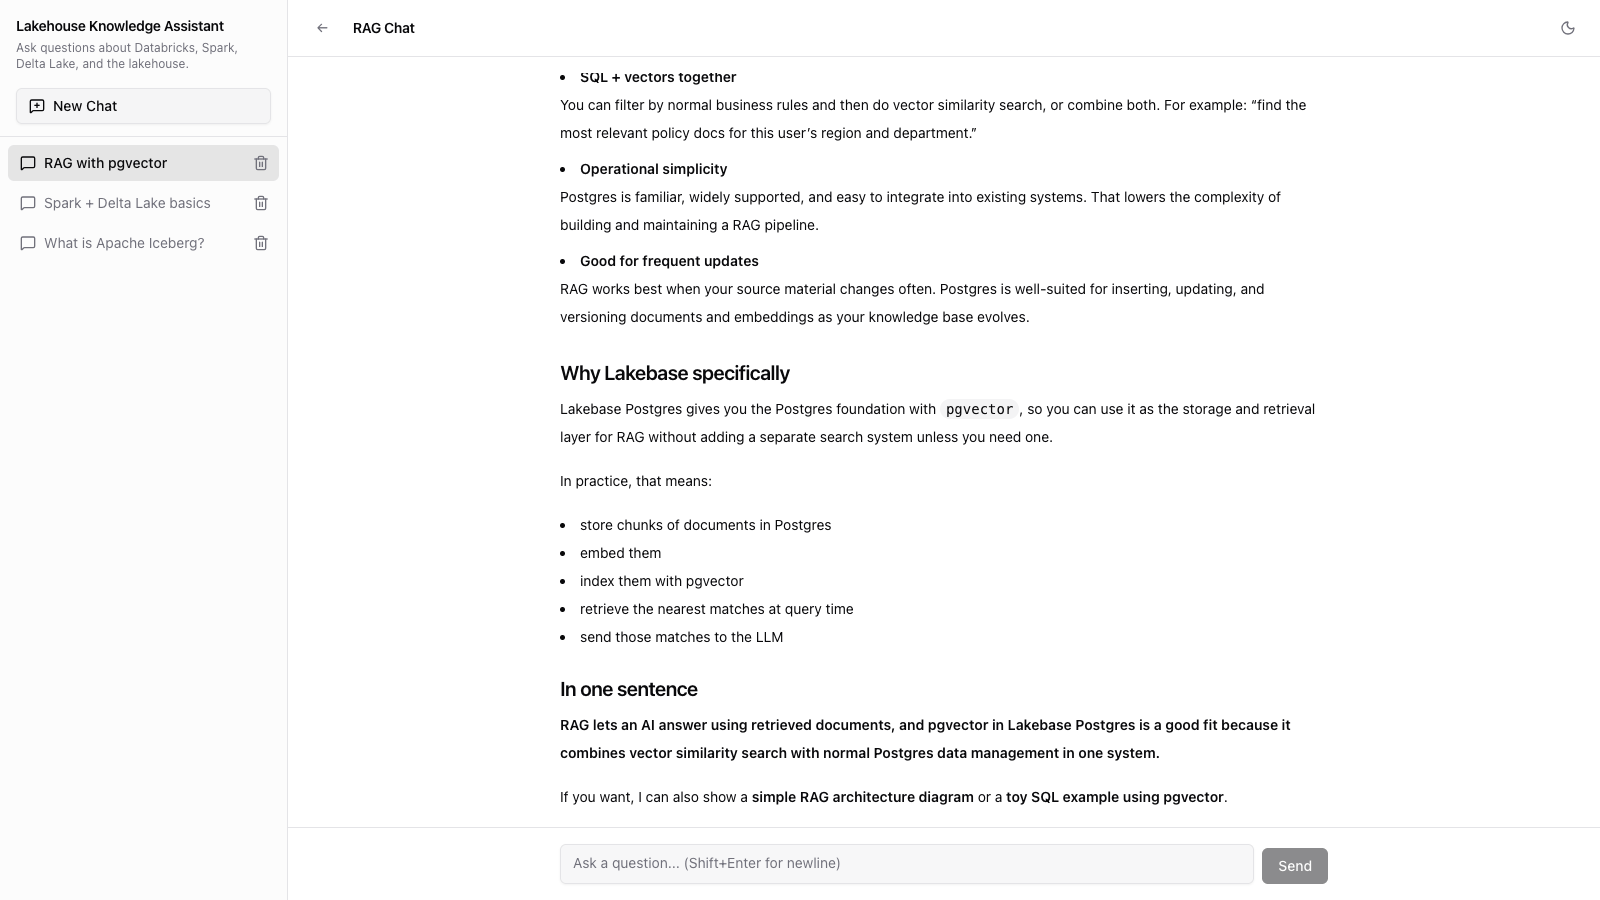
App de chat de geração aumentada por recuperação com streaming, recuperação via pgvector no Lakebase, corpus inicial da Wikipedia, geração com Model Serving e histórico de chat armazenado no Lakebase. Disponível via `databricks apps init`.
Crie com IA
- Copie o prompt abaixo
- Cole-o no Cursor, Claude Code, Codex ou em qualquer agente de programação
- Seu agente cria o app, fazendo perguntas ao longo do processo para que o resultado seja exatamente como você deseja
Não conhece os modelos? Saiba mais aqui
Inclui um app inicial funcional
O código funcional e executável está no GitHub. Ao copiar o prompt acima, seu agente de programação o clona como ponto de partida e o adapta aos seus dados e caso de uso.
Este modelo demonstra um aplicativo de chat com Retrieval-Augmented Generation construído no Databricks: a pergunta do usuário é convertida em embedding, documentos semelhantes são recuperados de um repositório pgvector no Lakebase Postgres e o contexto recuperado é injetado em uma chamada de Model Serving que retorna a resposta em streaming. As conversas e as fontes são persistidas por chat no Lakebase.
Fluxo de dados
Todo o estado de recuperação e de chat reside no Lakebase Postgres; a geração usa o Model Serving:
- A carga inicial busca alguns artigos da Wikipédia na inicialização, divide-os em blocos por parágrafo, gera os embeddings de cada bloco por meio do endpoint de embeddings de modelos de fundação (
databricks-gte-large-enpor padrão) e grava as linhas emrag.documentscom uma colunavector(1024). - Os turnos do usuário são convertidos em embeddings pelo mesmo endpoint. O servidor executa uma busca por similaridade de cosseno com pgvector para recuperar os top-k blocos correspondentes.
- Injeção de contexto: os blocos recuperados são inseridos no início como uma mensagem de sistema, antes que o histórico de conversa do usuário seja enviado ao endpoint de chat completion (
databricks-gpt-5-4-minipor padrão) via Model Serving. - Streaming: o
streamTexttransmite os tokens de volta ao cliente enquanto um callbackonFinishacrescenta o turno do assistente ao Lakebase. - Histórico de chat: cada turno do usuário e do assistente é persistido em
chat.messages, com chavechat_id, permitindo retomar as conversas.
Abordagem do modelo
Diferentemente dos outros modelos, este modelo foi projetado para ser consumido via databricks apps init, e não git clone. O fluxo de init:
- Solicita os nomes da branch do Lakebase Postgres e do recurso de banco de dados.
- Resolve automaticamente
PGHOST,PGDATABASEeLAKEBASE_ENDPOINTno seu.envlocal, chamando as APIs do Lakebase. - Grava
DATABRICKS_CONFIG_PROFILEouDATABRICKS_HOSTcom base na sua configuração do Databricks CLI. - Leva você direto a um diretório de projeto pronto para execução, com o nome definido por
--name.
Isso valida o sistema de modelos do AppKit como uma forma de distribuir modelos do DevHub — veja appkit.plugins.json e .env.tmpl no modelo para entender como funciona.
O que adaptar
A configuração e o provisionamento estão documentados no README.md do repositório.
Para adaptar este modelo às suas necessidades:
- Lakebase: aponte o bundle para o seu próprio projeto, branch e banco de dados Lakebase (solicitados no momento da inicialização).
- Model Serving endpoint: sobrescreva
DATABRICKS_ENDPOINTpara usar outro modelo de chat (por exemplo,databricks-claude-sonnet-4-6). - Endpoint de embeddings: sobrescreva
DATABRICKS_EMBEDDING_ENDPOINTse quiser usar outro modelo de embedding. Verifique se a dimensãovector(N)emserver/lib/rag-store.tscorresponde. - Dados de seed: substitua a lista de artigos da Wikipédia em
server/lib/seed-data.tspelo seu próprio corpus. A função de chunking divide o texto nos limites de parágrafo — adapte-a se a sua fonte tiver outra estrutura. - Recuperação: o top-k padrão é 5 e a métrica de similaridade é o cosseno. Ajuste em
retrieveSimilar().
Baseado nestes modelos
O código deste exemplo e o prompt do agente acima são baseados nos modelos abaixo. Abra um deles para explorar uma técnica específica isoladamente ou aplicá-la a outro projeto.
[MODELOS]
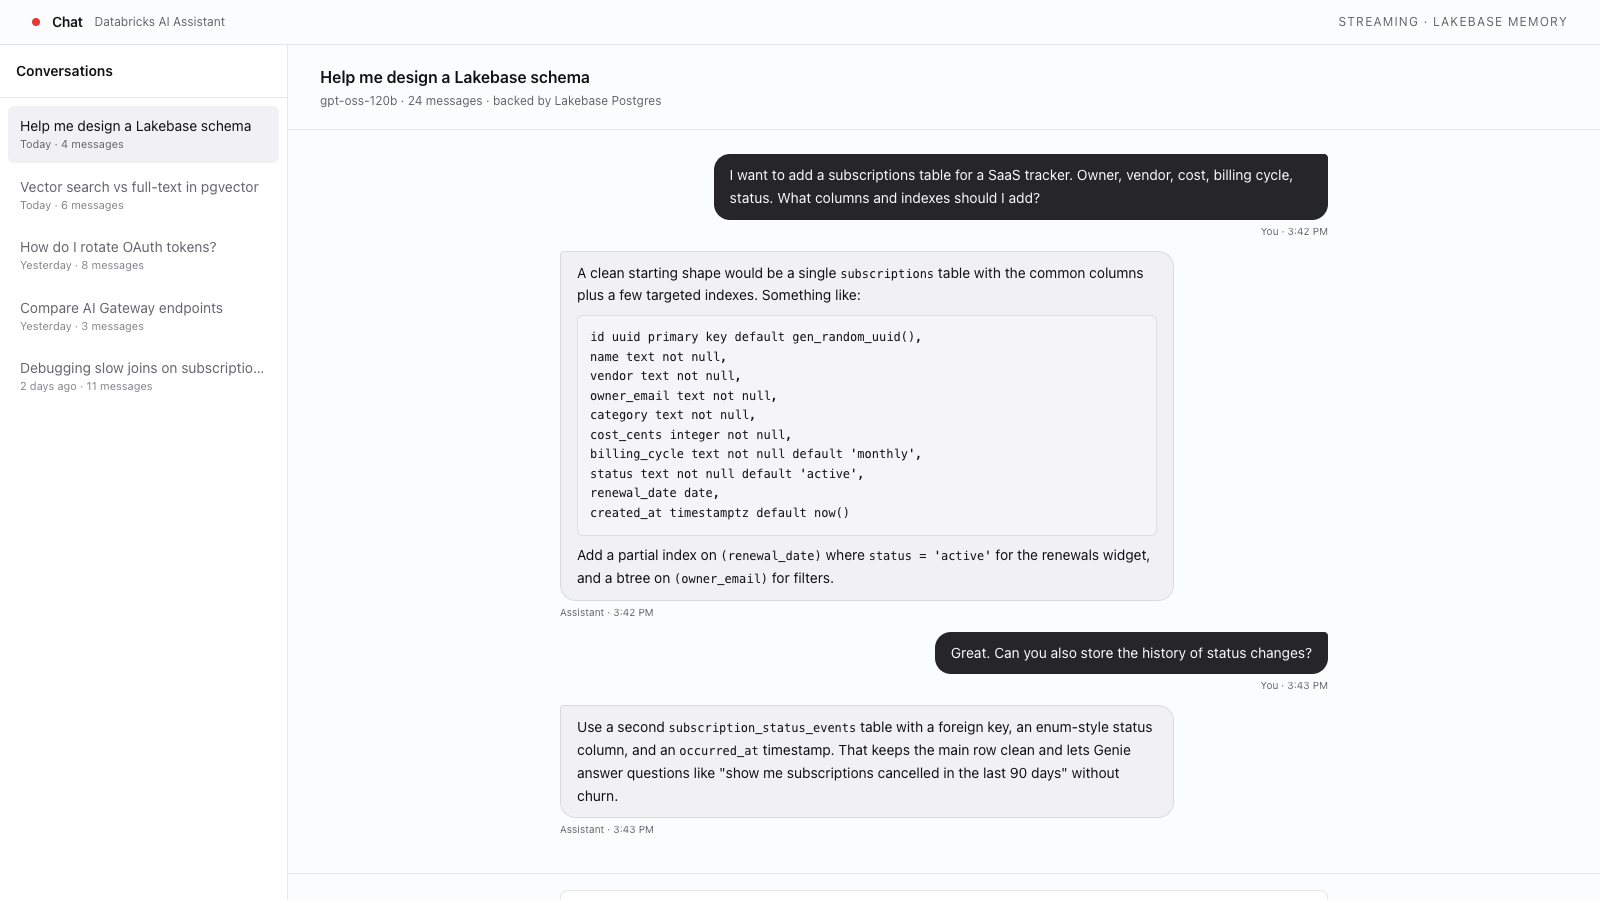
Aplicação de Chat de IA
Integração com Model Serving, chat com streaming do AI SDK e histórico de chat persistido no Lakebase.

[MODELOS]
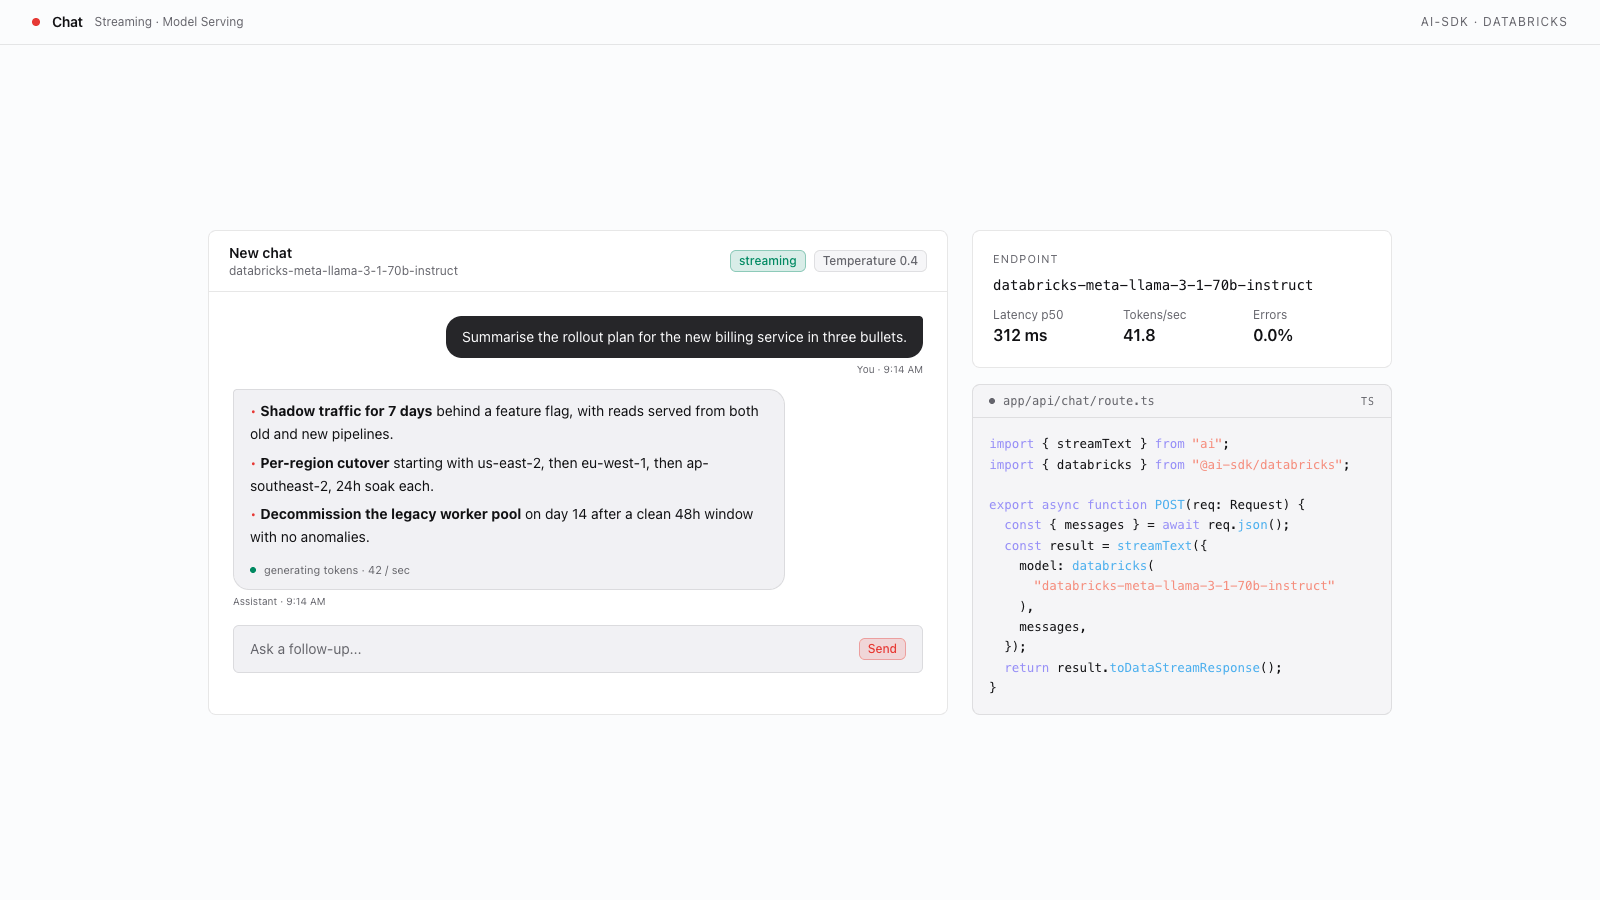
Chat de IA com Streaming usando Model Serving
Crie uma experiência de chat de IA com streaming usando o AI SDK e endpoints do Databricks Model Serving.
[MODELOS]
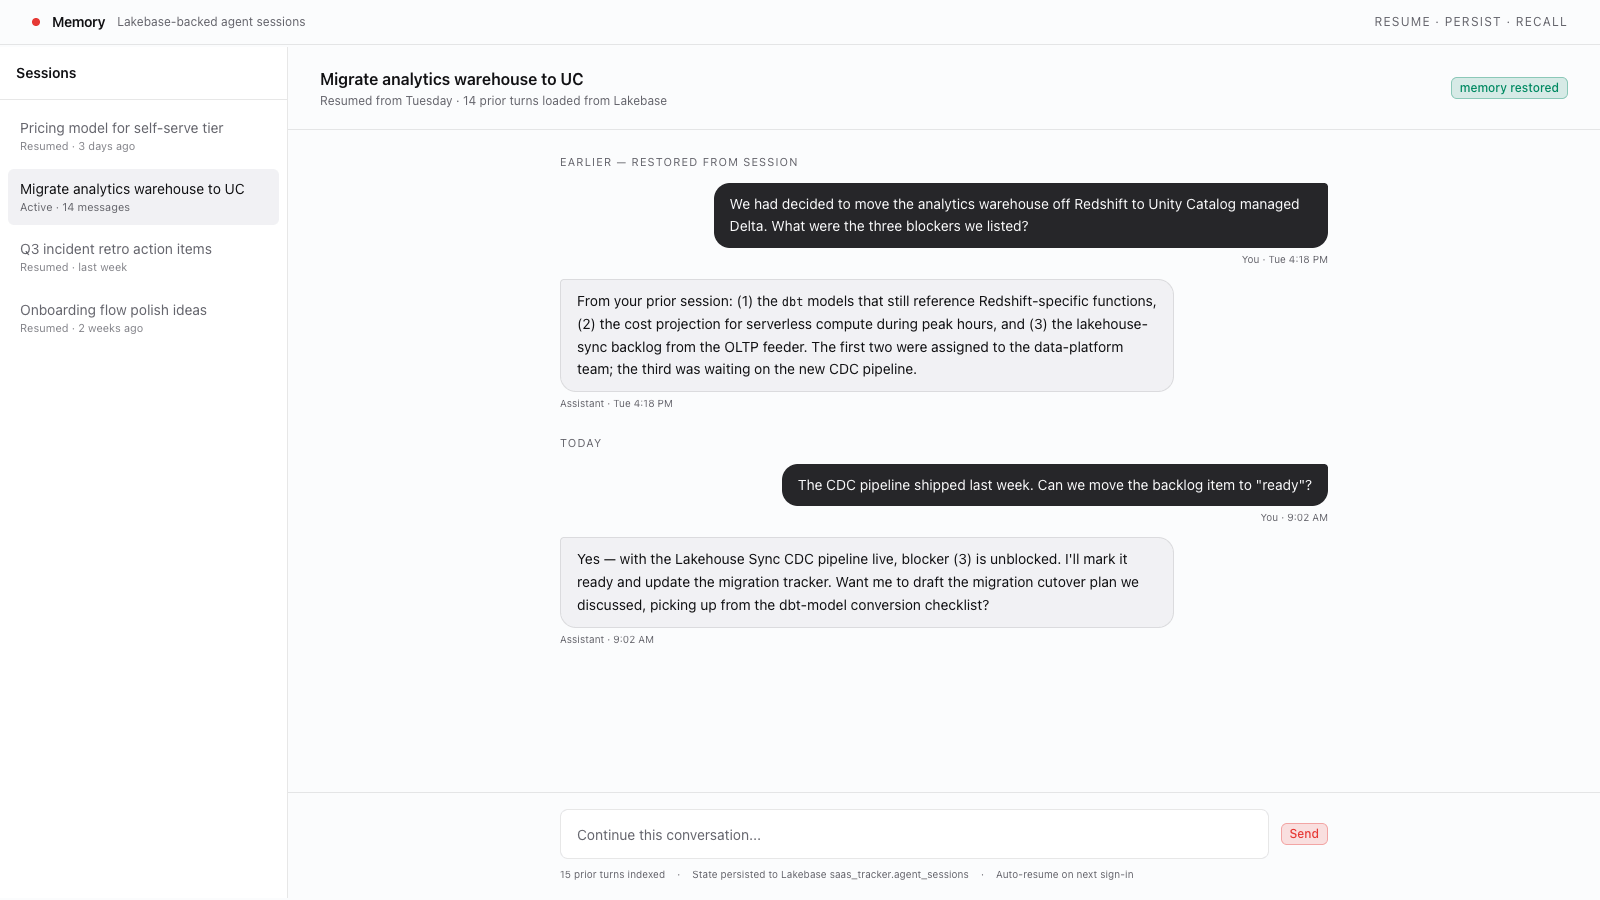
Memória de Agente do Lakebase
Persista as sessões e mensagens de chat do seu agente de IA no Lakebase para que os usuários possam retomar conversas e seu agente possa raciocinar sobre interações anteriores entre implantações.