Sincronize Tabelas: Unity Catalog para Lakebase (Autoscaling)
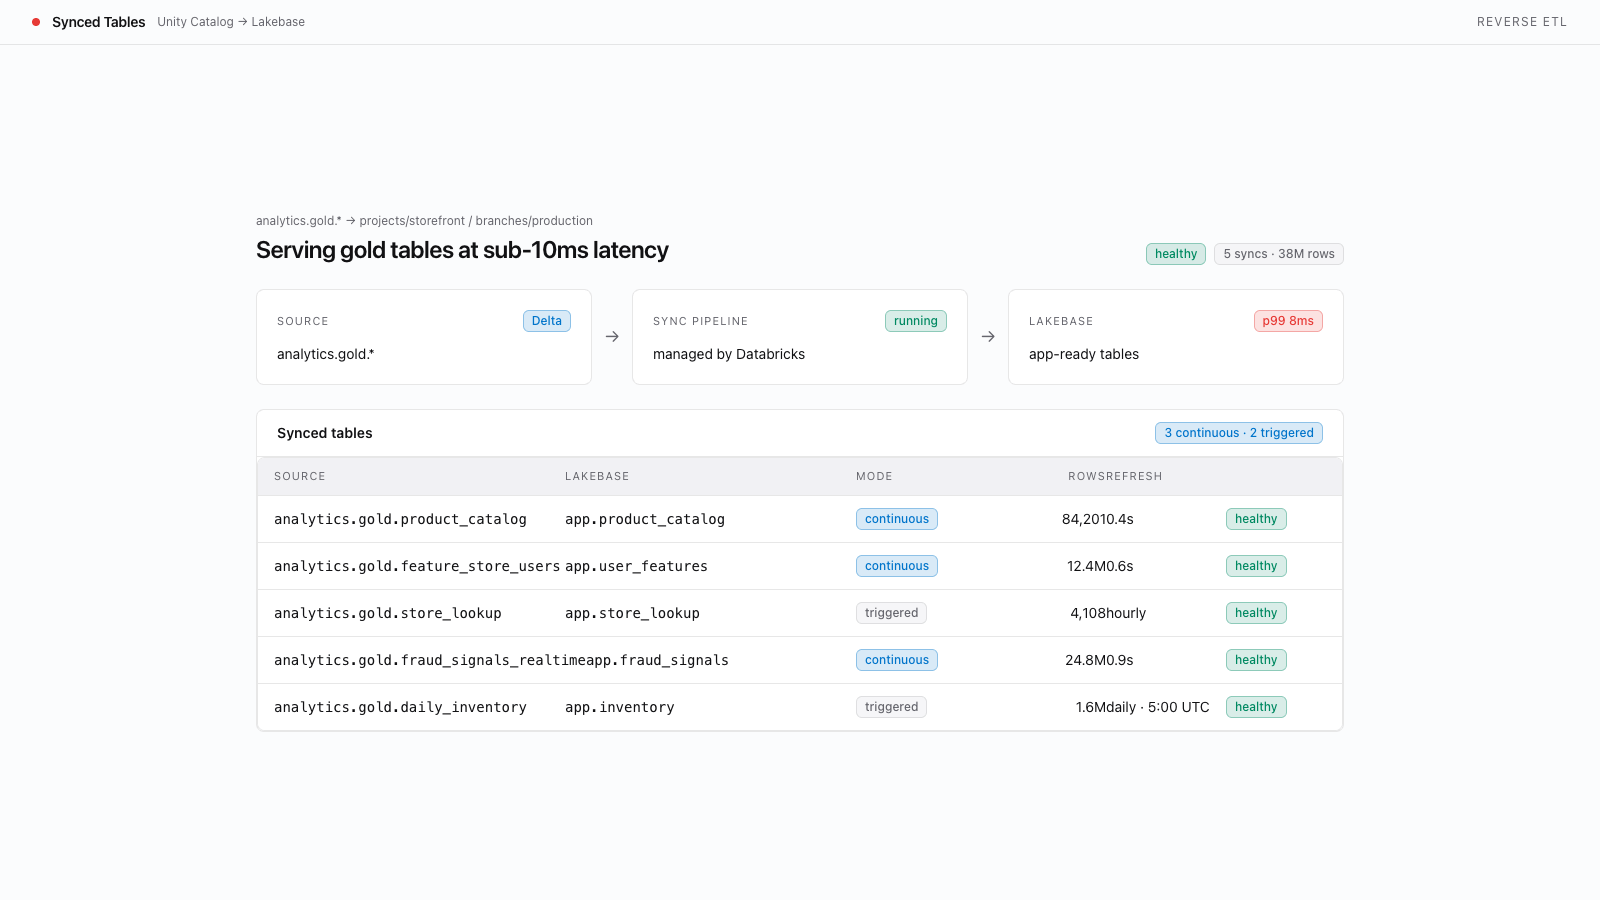
Sincronize tabelas do Unity Catalog com o Lakebase Autoscaling Postgres como tabelas sincronizadas para consultas de aplicações de baixa latência, nos modos de snapshot, acionado ou contínuo.
Crie com IA
- Copie o prompt abaixo
- Cole-o no Cursor, Claude Code, Codex ou em qualquer agente de programação
- Seu agente cria o app, fazendo perguntas ao longo do processo para que o resultado seja exatamente como você deseja
Não conhece os modelos? Saiba mais aqui
Ao concluir, você terá:
- Uma tabela sincronizada no Unity Catalog que acompanha o pipeline de replicação
- Uma tabela Postgres somente leitura no Lakebase, consultável com baixa latência a partir de qualquer cliente Postgres padrão
- Um pipeline gerenciado do Lakeflow que mantém os dados sincronizados nos modos snapshot, acionado ou contínuo
Prerequisites
Este modelo cria uma synced table que espelha uma tabela do Unity Catalog no Lakebase Postgres. Antes de começar, verifique se estes recursos do workspace Databricks estão habilitados.
- Lakebase Autoscaling disponível. Execute
databricks postgres list-projects --profile <PROFILE>e confirme que seu projeto com Autoscaling aparece na lista. Um erronot enabledindica que o Lakebase não está disponível para essa identidade. - CLI com suporte a synced table. Synced tables em projetos com Autoscaling são criadas com
databricks postgres create-synced-table(Beta). Executedatabricks postgres create-synced-table --helpe confirme que o comando existe; se não existir, atualize o Databricks CLI. Você também pode criar synced tables pela UI do Databricks (Catalog → tabela de origem → Create synced table). - Tabela de origem no Unity Catalog. Execute
databricks tables get <CATALOG>.<SCHEMA>.<SOURCE_TABLE> --profile <PROFILE>e confirme que a origem existe; em seguida, defina qual(is) coluna(s) servirá(ão) como chave primária da synced table — você as informa emprimary_key_columnsna especificação de criação. A origem não precisa ter uma restrição de chave primária declarada. - Change Data Feed habilitado na tabela de origem (apenas para os modos Triggered / Continuous). Ignore esta verificação se pretende usar o modo Snapshot. Caso contrário, execute a instrução
ALTER TABLE <catalog>.<schema>.<table> SET TBLPROPERTIES (delta.enableChangeDataFeed = true);do Passo 1 no seu SQL warehouse.